对于文法G(S)的非终结符
,定义:
由上至下分析
从文法的开始符号出发,反复使用各种产生式,寻找“匹配”的推导,自顶向下分析也可以看作是从开始符号出发,寻找输入串的最左推导过程。自顶向下语法分析的关键问题是对于非终结符
,应该选择哪个产生式。
推导:根据文法的产生式规则,把串中出现的产生式左部符号替换成右部符号。
分析方法:递归下降分析法,预测分析法
递归下降分析法
分析程序由一组子程序组成,对于每个语法单位(非终结符)构造一个相应的子程序,识别对应的语法单位,通过子程序间的相互调用实现对输入串的识别。
void A(){
选择一个A的产生式
for(i=1 to k){
if(
是一个非终结符)调用过程
;
else if(
等于当前输入符号a)读入下一个输入符号;
else 不匹配当前候选式,尝试下一个
}
}
递归下降分析存在以下问题:
直接左递归消除:
变换为:
间接左递归消除:
- 把文法G的所有非终结符按任意一种顺序排列
- FOR i=1 TO n DO
FOR j=1 TO i-1 DO
把形如
的规则改写成
(其中
是关于
的所有规则)
消除关于
规则的直接左递归 - 化简由2所得的文法,去除从开始符号出发永远无法到达的非终结符的产生规则。
对于文法G(S)中的任何非终结符
,修改文法使其满足以下条件以消除回溯。
- 消除左递归
- 提取左公共因子使得
。
- 检查是否满足
。
LL(1)文法
满足以下条件的文法既为LL(1)文法:
- 文法不含左递归
- 文法中的每个非终结符A的各个产生式的候选首符集两两不相交。既,若
则
。
- 对文法中的每个非终结符A,若它的候选首符集包含
,则需满足
。
LL(1)文法不是二义的。
预测分析法
对于输入符号a和LL(1)文法中的语法单位
,若
则选择
候选式,若
且
,则选择
候选式,否则a的出现属于语法错误。
构建文法G的预测分析表M:
- 对于
中的每个终结符号a,将
加入到
中。
- 如果
在
中,那么对于
中的每个终结符号b,将
加入到
中,如果
在
中,且#(结束符)也在
中,也将
加入到
]$中。
- 将M中没有产生式的位置设置为error。
如果文法G是左递归或二义的,那么M至少含有一个多重定义入口。一个文法的预测分析表M不含多重定义入口,当且仅当该文法为LL(1)的。
预测分析算法:
输入:串
,文法G(S)的预测分析表M
输出:如果
在L(G)中,输出
的一个最左推导;否则给一个错误提示
过程:
stack.push(#S)
ip = 当前符号a的地址
X = stack[top];
while(X != #){
if(X == a){stack.pop(),ip++;}
else if(X == 除a以外的终结符号)error();
else if(M[X,a] == error)error();
else if(M[X,a] ==
){
stack.pop();
stack.push(
)
}
X = stack[top];
};
扩充的巴科斯范式
在巴科斯范式元语言符号"
“的基础上扩充几个元语言符号:
- 用花括号
表示闭包运算
- 用
表示可任意重复0至n次
- 用方括号
表示
,既表示
的出现可有可无(等价于
)
对于巴科斯范式文法G(E):
可以使用扩充的巴科斯范式表示成:
使用扩充的巴科斯范式描述语法,便于表示左递归的消除和公因子的提取,以及程序实现。
由下至上分析
从输入串开始,逐步进行规约,直到文法的开始符号。自顶向下语法分析的关键问题是寻找可规约串。
规约:根据文法的产生式规则,把其中出现的产生式的右部替换为左部符号。
分析方法:算符优先分析法、LR分析法
算符优先分析法
按照算符的优先关系和结合性质进行语法分析,适合用来分析表达式。对于算符优先分析,可以使用最左素短语定理来确定可规约串。pratt parser算法就是一个算符优先分析法。
算符文法:
对于文法G(S),如果它的任一产生式都不包含…QR…形式的右部,则称该文法为算符文法。
算符优先文法:
对于不含
产生式的算符文法G(S)的任何一对终结符a,b,我们说:
-
,当且仅当文法G中含有形如
的产生式;
-
,当且仅当G中含有形如
的产生式,且
;
-
,当且仅当G中含有形如
的产生式,且
;
如果一个算符文法G中的任何终结符对(a,b)至多只满足
三者之一,则称G是一个算符优先文法。
构造算符优先关系表:
对于算符优先文法G(S),定义:
根据FIRSTVT和LASTVT集合,检查每个产生式的候选式,确定满足关系
的所有终结符对:
假设有个产生式有一个形为…aP…的候选式,那么,对于任何
,有
。
假设有个产生式有一个形为…Pb…的候选式,那么,对于任何
,有
。
根据以上信息,创建算符优先关系表M[a,b]。
短语和直接短语:
假设
是文法G(S)的一个句型,如果有
且
,则称
是句型
相对于非终结符A的短语。
如果有
,则称
是句型
相对于规则
的直接短语。
素短语和最左素短语:
对于文法G(S)的一个短语,若它至少包含一个终结符,且除它自身外不再包含任何更小的素短语,则称这个短语为素短语。
最左素短语指处于句型最左边的那个素短语。
最左素短语定理:
对于算符优先文法句型(括在两个#之间)的一般形式:
#
#
其中,
都是终结符,
是可选的非终结符。
定理:一个算符优先文法G的任何句型的最左素短语是满足如下条件的最左子串
:
-
(
优先级大于左侧)
-
(子串内部优先级相同)
-
(
优先级大于右侧)
算符优先分析算法:
输入:串
#,算符优先关系表M
输出:一个分析树,不一定是语法树,因为跳过了
形式的规约
算法:
stack[top] = #;
do{
a=next_token();
if(stack[k]
)j=stack.top;
else j=stack.top-1;
while(stack[j]
a){
//寻找最左素短语
do{
Q = stack[j];
if(stack[j-1]
)j = j-1;
else j = j-2;
}until(stack[j]
Q);
//把stack[j+1]…stack[top]规约为某个非终结符N,从左到右,终结符对相同终结符,非终结符对非终结符(可以不同)
stack.pop(stack[j+1]…stack[top]);
stack.push(N);
}
if(stack[j]
a || stack[j]
a)stack.push(a);
else error();
}until(a==#);
LR分析法
LR分析法是一个规范规约过程,使用句柄作为其可规约串。规范规约的关键问题是寻找句柄。
句柄: 一个句型的最左直接短语称为该句型的句柄。
规范规约:
假设
是文法G(S)的一个句子,则满足下列条件的句型序列
是
的一个规范规约:
- 对于任何i(0<i<=n),
是从
经把句柄替换成相应产生式的左部符号而得到的
规范句型:
规范规约是最左规约,规范规约的逆过程就是最右推导,最右推导也称规范推导,由规范推导推出的句型称为规范句型。
LR文法:
对于一个文法,如果能够构造一张LR分析表,使得它的每个表项都是唯一确定的,则这个文法称为LR文法。
对于一个LR文法,如果能够用一个每步最多向前检查k个符号的LR分析器分析,则这个文法称为LR(k)文法。
LR文法不是二义的,二义文法肯定不是LR文法。LR文法是无二义文法的真子集(既:LR文法
无二义文法)。
LR分析表:
ACTION[S,a]: 当状态S面临输入符号a时,应采取什么动作(移进或规约)。
GOTO[S,X]: 状态S面对非终结符号X时,下一状态是什么。
LR分析过程:
LR分析使用状态栈存储分析状态
,使用分析栈存储分析过程#
,输入串为
#
对于格局(
,#
,
#)
LR分析器根据
确定下一步动作:
- 若
为移进,且S为下一状态,则格局变为:(
,#
,
#)
- 若
为按
规约,则格局变为:(
,#
,
#),此处
,r=length(
),
- 若
为“接受”,则格局变化过程终止,分析成功
LR(0)分析法
活前缀:
指规范句型的一个前缀,这种前缀不含句柄之后的任何符号。既,对于规范句型
,
为句柄,如果
,则符号串
是
的活前缀。(
必为终结符串)。
在LR分析过程中的任何时候,分析栈中的文法符号应该构成活前缀。规范规约过程中,LR分析表保证分析栈中总是活前缀,就说明分析采取的移进/规约动作是正确的。
对于一个文法G,可以构造一个DFA识别G的所有活前缀。
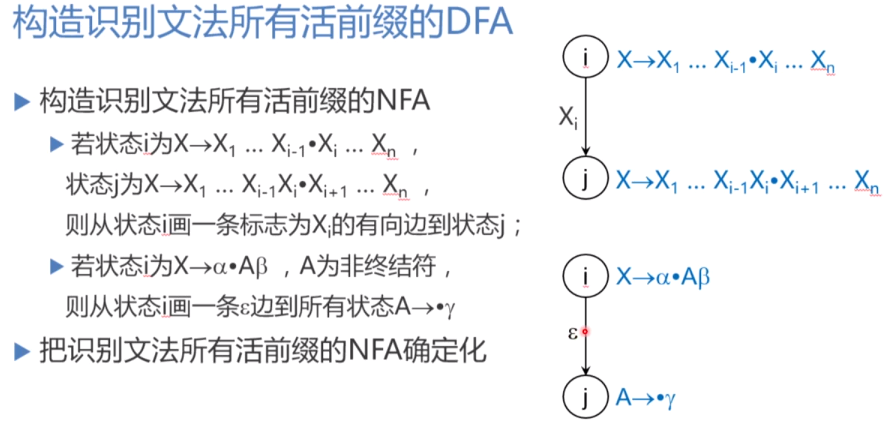
拓广文法:
构造文法G’,它包含了整个G,并引进不出现在G中的非终结符号S’,以及产生式
,S’是G’的开始符号,则称G’是G的拓广文法。
拓广文法的目的是保证文法的开始符号只有一个产生式,且开始符号不会出现在其他产生式的右部。这样就保证了G’只有唯一的"接受"状态,既,仅含项目
的状态。
LR(0)项目:
在每个产生式的右部添加一个圆点,表示在分析过程中已经看到的产生式的部分,例如
有四个项目”
"
称为"规约项目";
规约项目
称为"接受项目";
称为"移进项目";
称为"待约项目";
有效项目:
项目
对活前缀
是有效的,其条件是存在规范推导
在任何分析栈中的活前缀
的有效项目集正是从识别活前缀的DFA的初态出发,读出
后到达的那个项目集(状态)。
有效项目具有如下性质:若项目
对活前缀
是有效的且
是一个产生式,则项目
对
也是有效的。
LR(0)项目集规范族的构造:
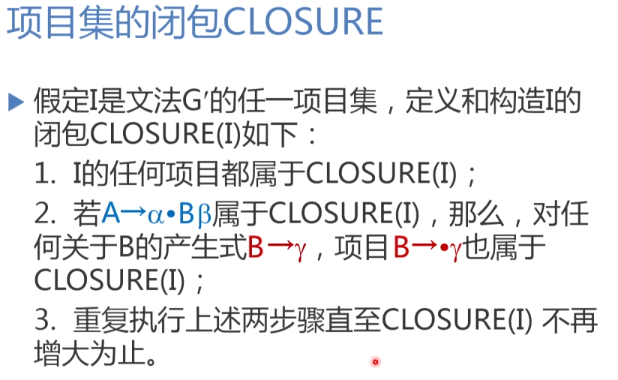
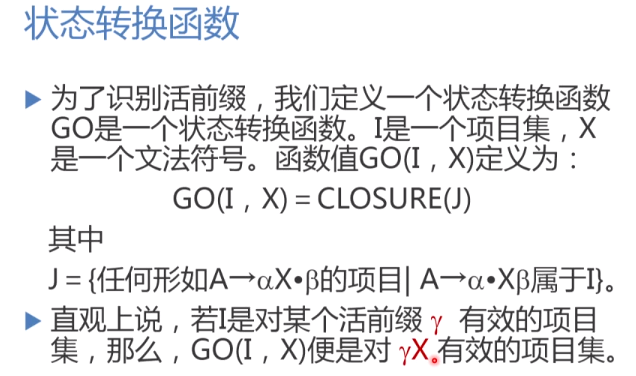
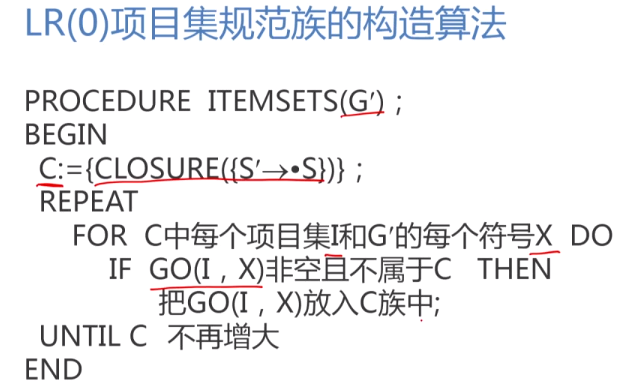
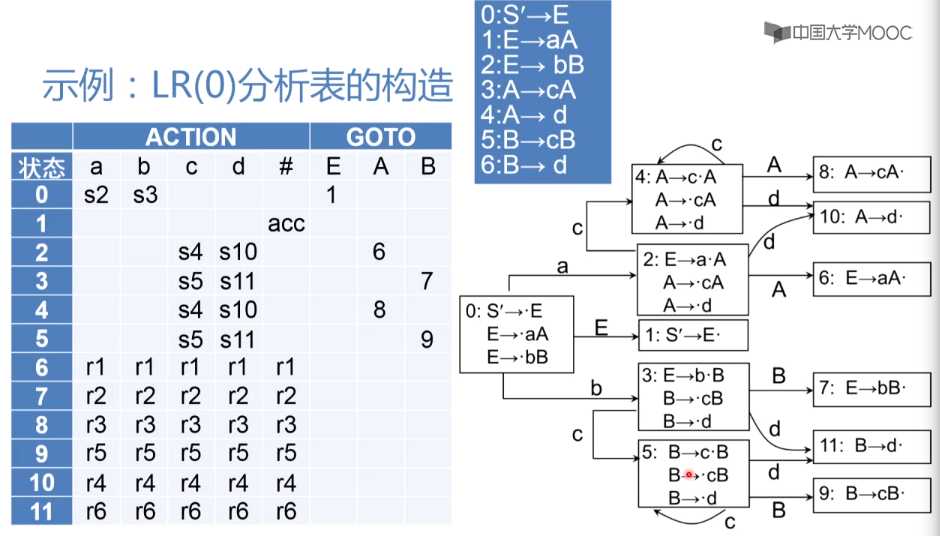
LR(0)文法:
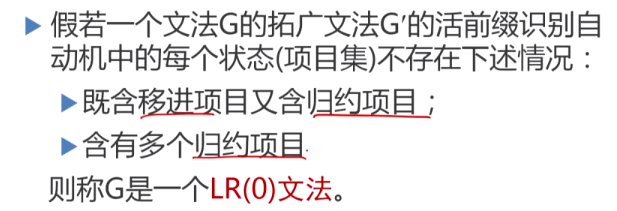
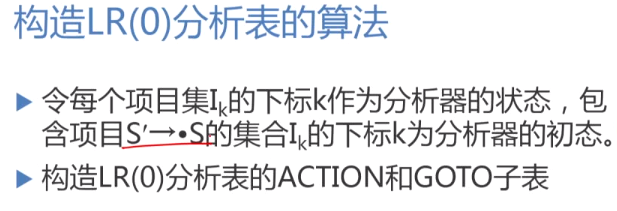
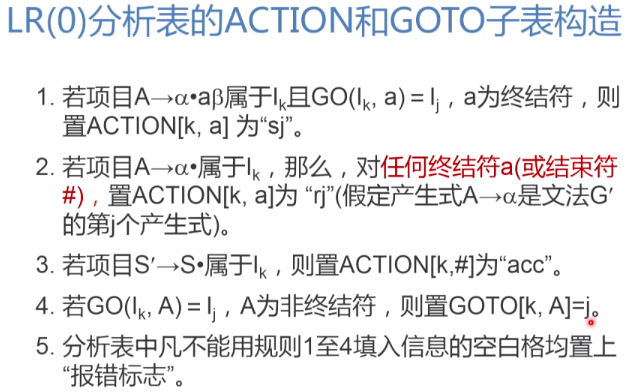
LR(0)分析表的构造:
SLR(1)分析法
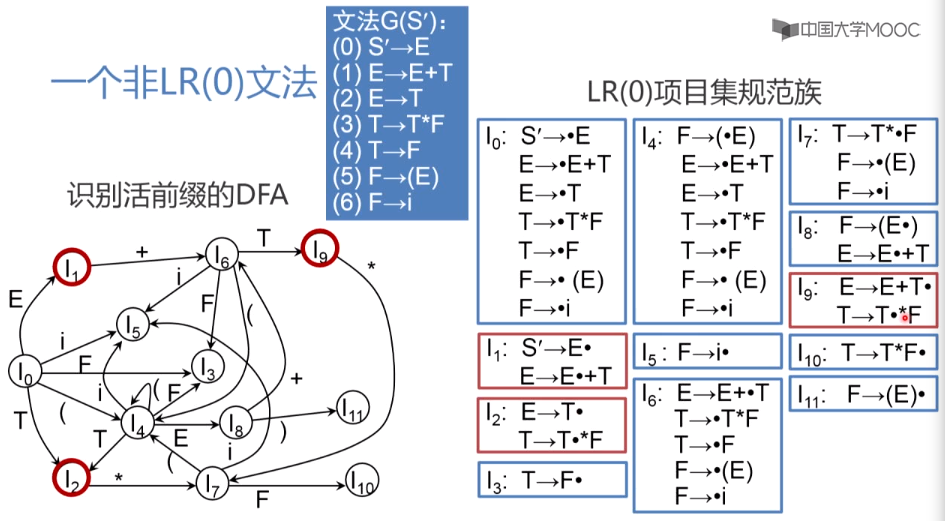
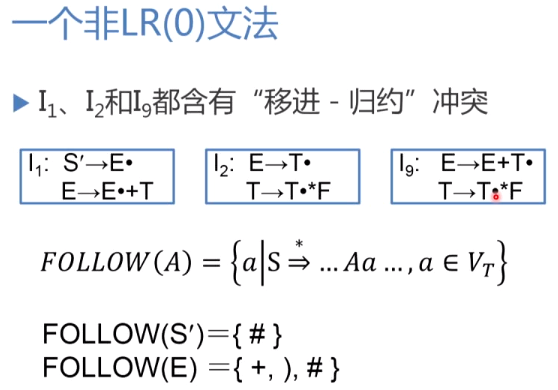
非LR(0)文法的项目集冲突:
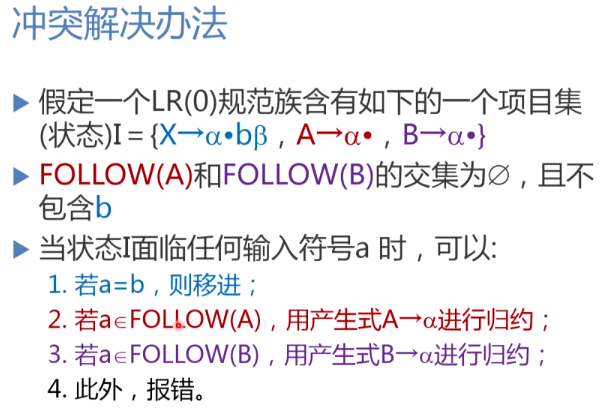
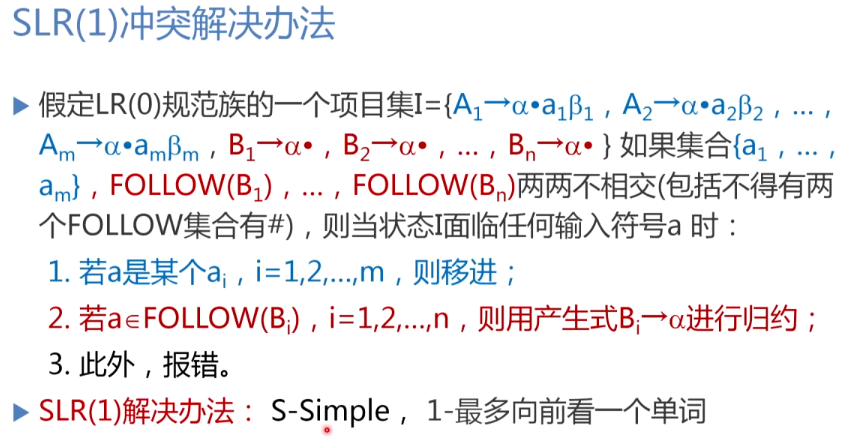
SLR(1)冲突解决方法:
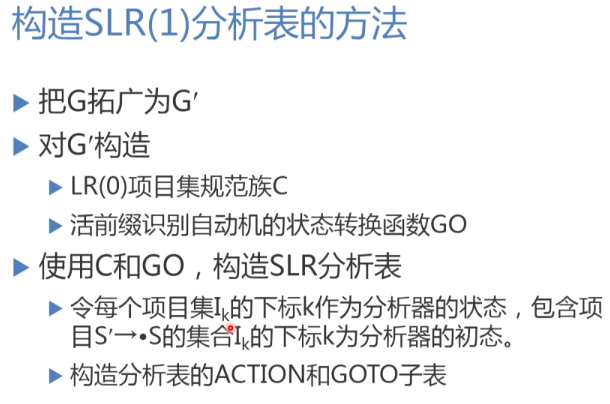
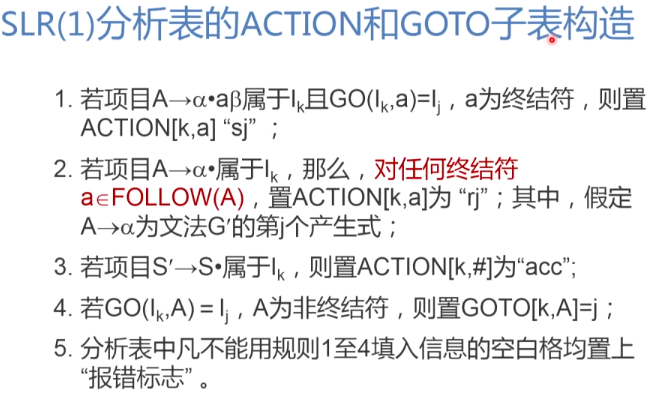
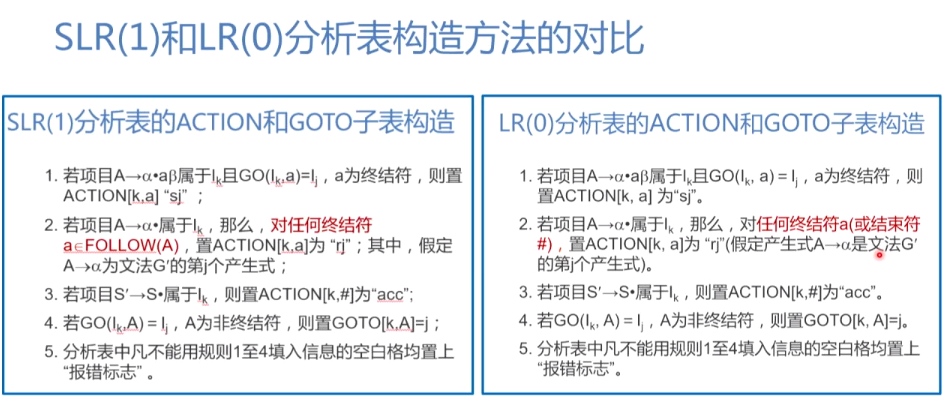
构造SLR(1)分析表的方法:
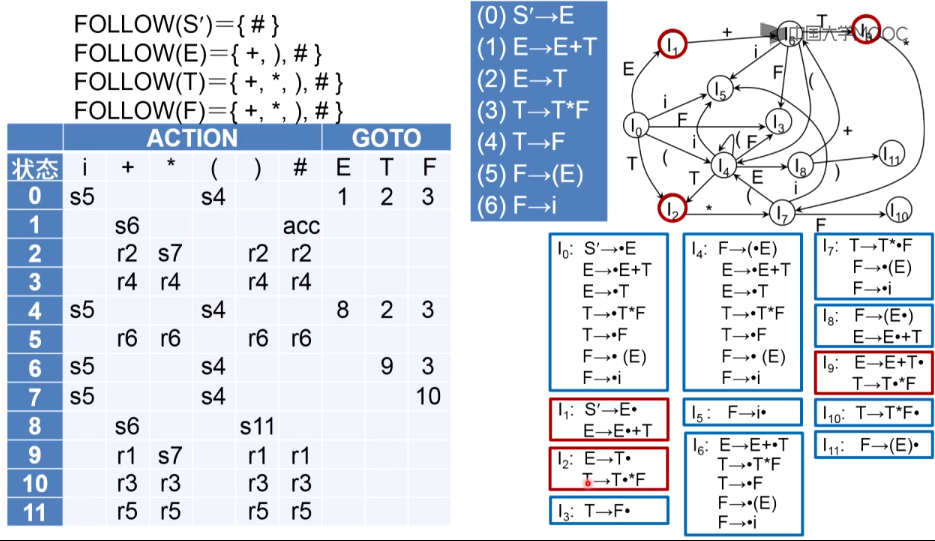
SLR(1)文法:
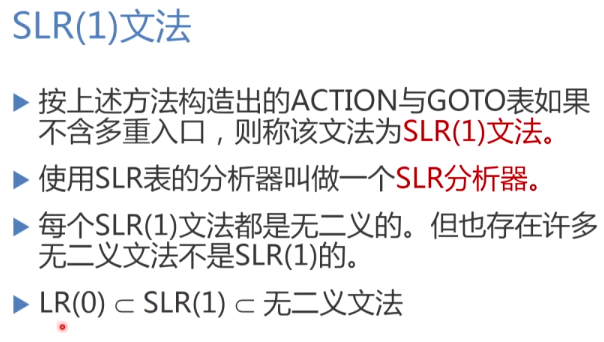
LR(1)分析法
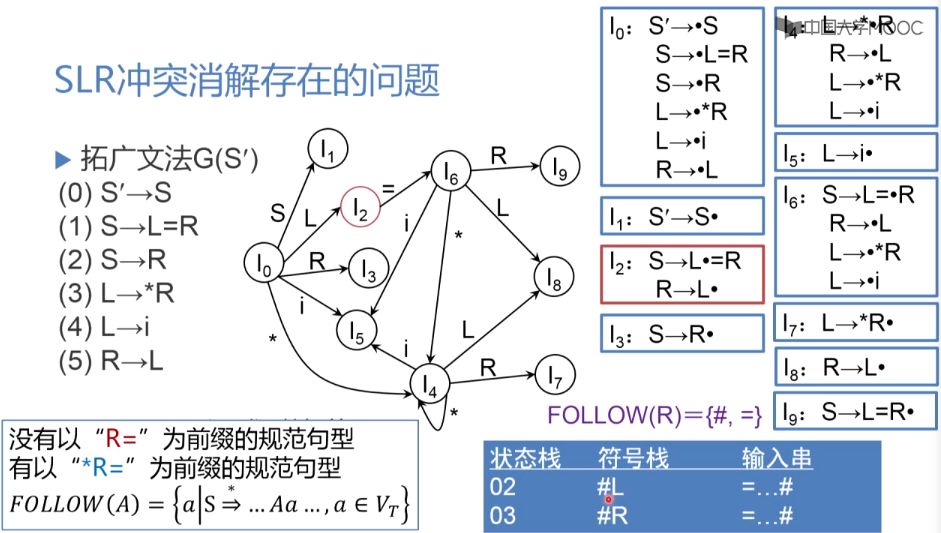
SLR(1)冲突消解存在的问题:
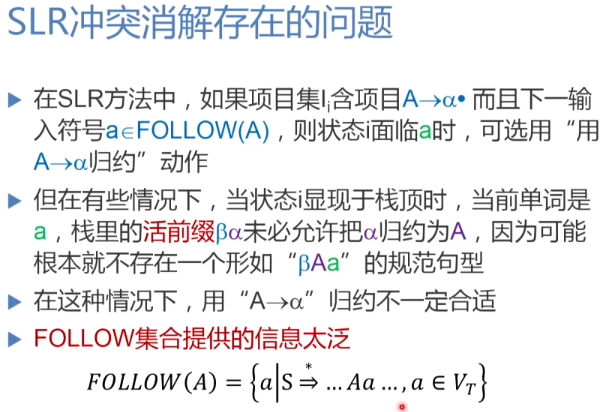
对于一个非SLR(1)文法,SLR(1)归约可能使得分析栈中出现一个非活前缀(此前缀不是规范句型的前缀),出现此情况的原因是FOLLOW集合提供的信息太泛,不能体现当前活前缀或分析状态对拟归约生成的非终结符A后面的符号的具体约束,而是泛泛的接受所有可能出现在A后面的单词,这是由FOLLOW集合的定义决定的,因此需要更加精细的预测信息,要能够根据当前栈中的活前缀和状态组成的格局来选择下一个能够接受的单词。
LR(k)项目:
通常取k<=1的情形,向前展望1个符号即可确定移进还是归约,k值过大会使分析表状态爆炸。
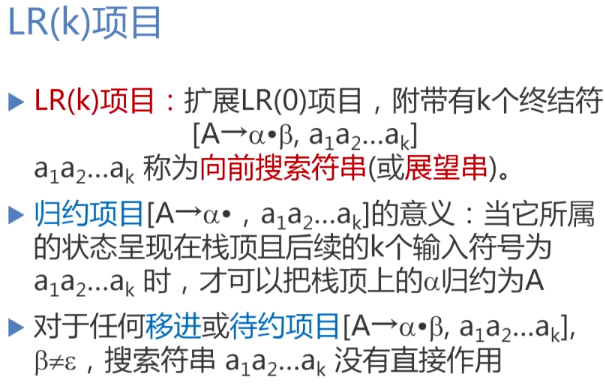
移进或待约项目的搜索符号串会间接传递给归约项目。
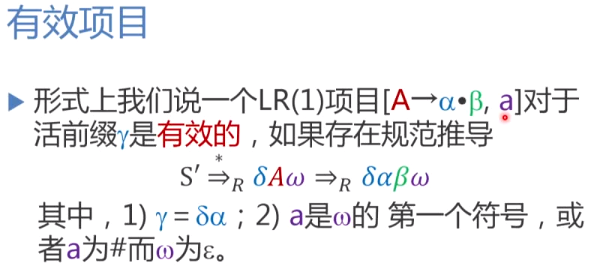
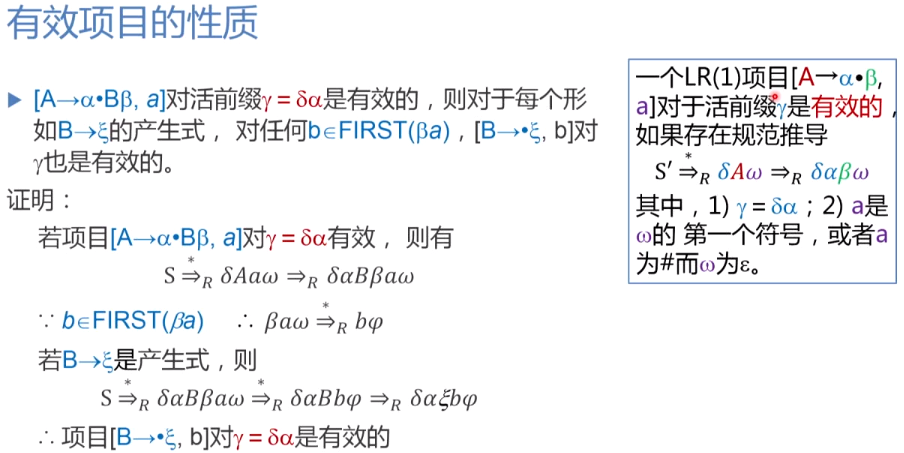
LR(1)有效项目:
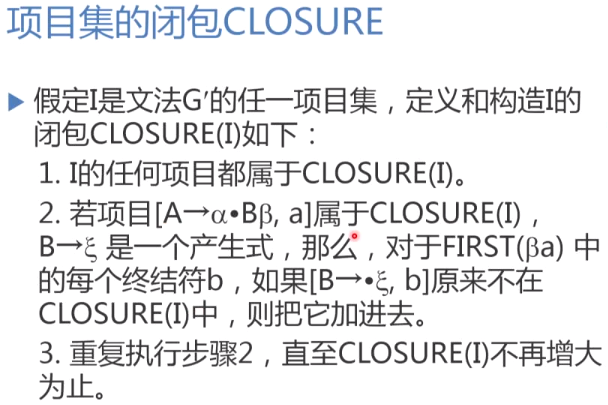
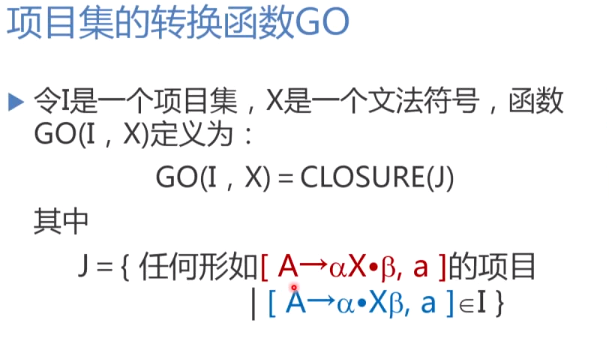
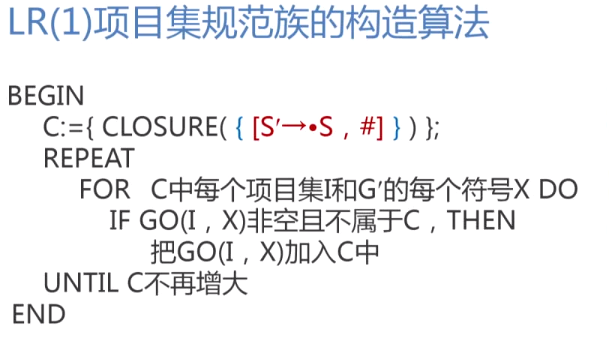
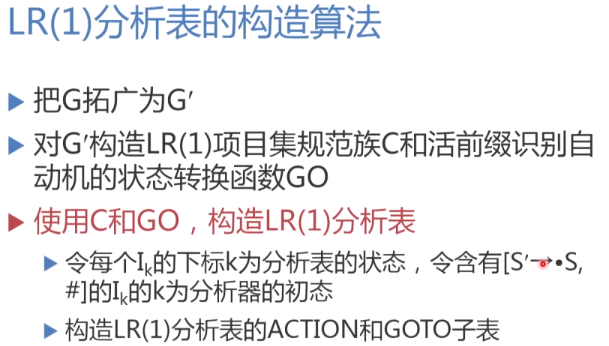
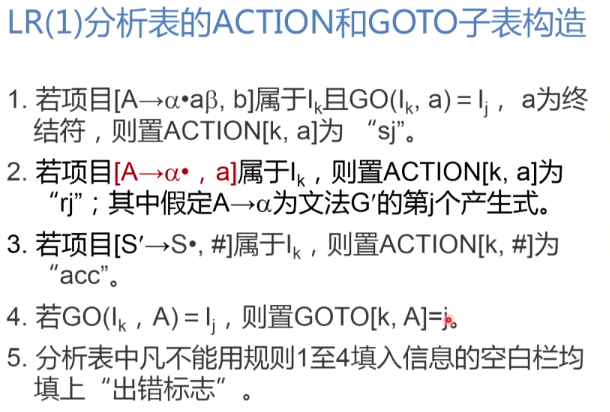
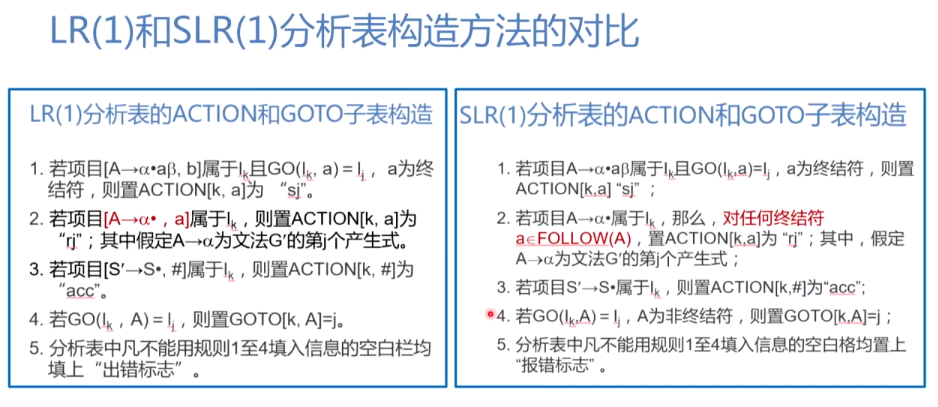
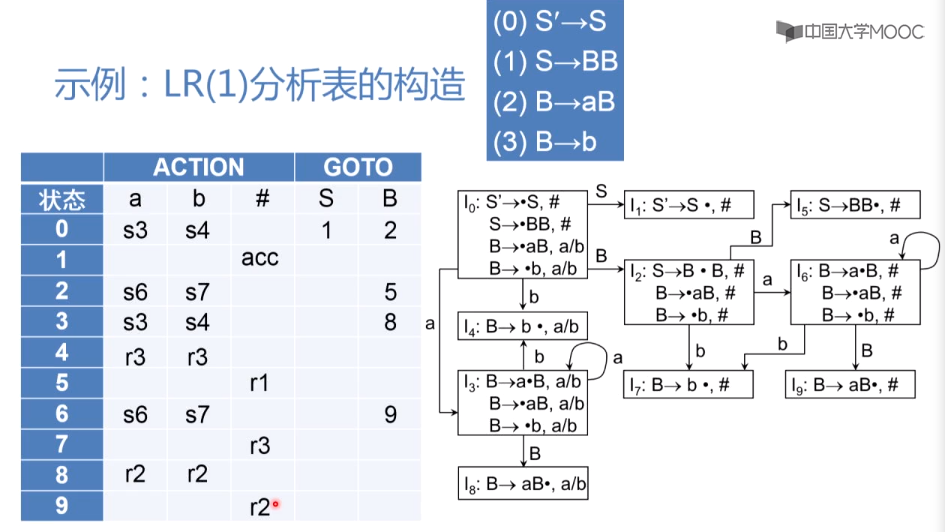
LR(1)分析表的构造:
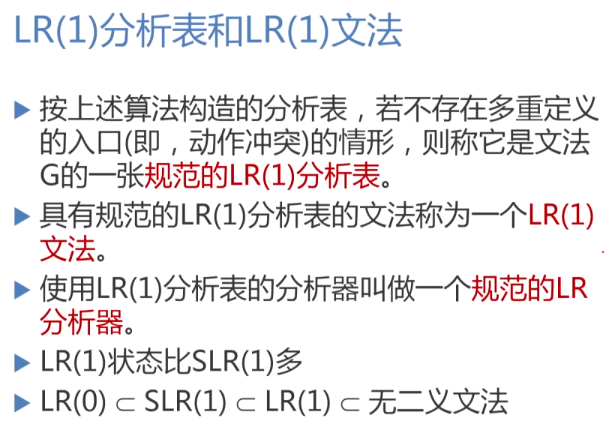
LR(1)文法: