块设备可以随机访问,对于I/O请求有对应的缓冲区,因此它们可以选择以什么顺序进行响应。块I/O调度层负责进行排序和合并,I/O调度层的基本目的是将请求按照它们对应在块设备上的扇区号进行排列,以减少磁头的移动,提高效率。
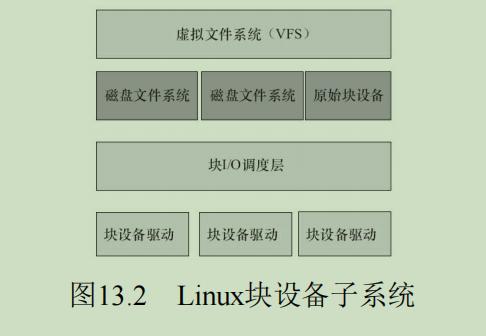
块设备驱动结构
在块设备驱动中,有一个类似于字符设备驱动中file_operations结构体的block_device_operations结构体,它是对块设备操作的集合。
struct block_device_operations {
	int (*open) (struct block_device *, fmode_t);
	void (*release) (struct gendisk *, fmode_t);
	int (*rw_page)(struct block_device *, sector_t, struct page *, int rw);
	int (*ioctl) (struct block_device *, fmode_t, unsigned, unsigned long);
	int (*compat_ioctl) (struct block_device *, fmode_t, unsigned, unsigned long); // 一个64位系统内的32位进程调用的是compat_ioctl()
	int (*direct_access) (struct block_device *, sector_t,
	void **, unsigned long *);
	unsigned int (*check_events) (struct gendisk *disk, unsigned int clearing); // 监测可移动设备介质变动
	/* ->media_changed() is DEPRECATED, use ->check_events() instead */
	int (*media_changed) (struct gendisk *);
	void (*unlock_native_capacity) (struct gendisk *);
	int (*revalidate_disk) (struct gendisk *); // 可移动设备介质变动时进行初始化
	int (*getgeo)(struct block_device *, struct hd_geometry *); // 获取hd_geometry结构体包含的磁头、扇区、柱面等信息
	/* this callback is with swap_lock and sometimes page table lock held */
	void (*swap_slot_free_notify) (struct block_device *, unsigned long);
	struct module *owner;
};
gendisk结构
在Linux内核中,使用gendisk(通用磁盘)结构体来表示一个独立的磁盘设备(或分区)。
struct gendisk {
	/* major, first_minor and minors are input parameters only,
	* don't use directly. Use disk_devt() and disk_max_parts().
	*/
	int major; /* major number of driver */
	int first_minor;
	int minors; /* maximum number of minors, =1for
	* disks that can't be partitioned. */

	char disk_name[DISK_NAME_LEN]; /* name of major driver */
	char *(*devnode)(struct gendisk *gd, umode_t *mode);

	unsigned int events; /* supported events */
	unsigned int async_events; /* async events, subset of all */

	/* Array of pointers to partitions indexed by partno.
	* Protected with matching bdev lock but stat and other
	* non-critical accesses use RCU. Always access through
	* helpers.
	*/
	struct disk_part_tbl __rcu *part_tbl; // 分区表disk->part_tbl->part[0] = &disk->part0;
	struct hd_struct part0; // 第一个分区

	const struct block_device_operations *fops;
	struct request_queue *queue;
	void *private_data;

	int flags;
	struct device *driverfs_dev; // FIXME: remove
	struct kobject *slave_dir;

	struct timer_rand_state *random;
	atomic_t sync_io; /* RAID */
	struct disk_events *ev;
	#ifdef CONFIG_BLK_DEV_INTEGRITY
	struct blk_integrity *integrity;
	#endif
	int node_id;
};

struct gendisk *alloc_disk(int minors); // 动态分配gendisk结构体,需要内核来初始化,不能自己分配
void add_disk(struct gendisk *disk); // 注册磁盘设备,必须在驱动程序初始化工作完成并能响应磁盘的请求之后调用
void del_gendisk(struct gendisk *gp);
// 增加和减少引用计数
struct kobject *get_disk(struct gendisk *disk);
void put_disk(struct gendisk *disk);
bio、request、request_queue
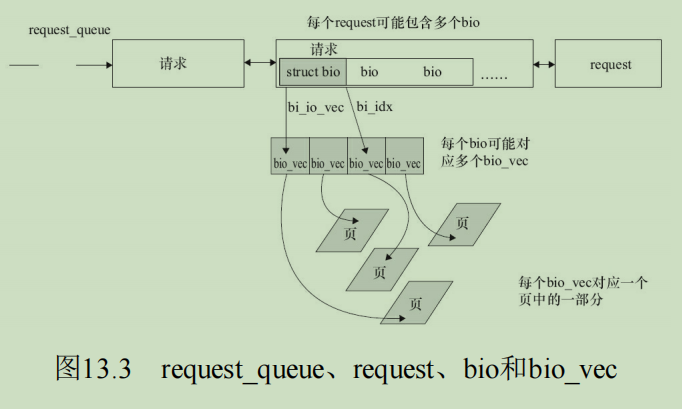
通常一个bio对应上层传递给块层的I/O请求。与bio对应的数据每次存放的内存不一定是连续的,bio_vec结构体(又称为segment)用来描述与这个bio请求对应的所有的内存,它可能不总是在一个页面里面,因此需要一个向量。I/O调度算法可将连续的bio合并成一个request。request是bio经由I/O调度进行调整后的结果,一个request可以包含多个bio。每个块设备或者块设备的分区都对应有自身的request_queue,从I/O调度器合并和排序出来的请求会被分发(Dispatch)到设备级的request_queue。
struct bio_vec {
	struct page *bv_page;
	unsigned int bv_len;
	unsigned int bv_offset;
};

/*
 * main unit of I/O for the block layer and lower layers (ie drivers and
 * stacking drivers)
 */
struct bio {
	struct bio *bi_next; /* request queue link */
	struct block_device *bi_bdev;
	unsigned long bi_flags; /* status, command, etc */
	unsigned long bi_rw; /* bottom bits READ/WRITE,
	* top bits priority
	*/

	struct bvec_iter bi_iter;

	/* Number of segments in this BIO after
	* physical address coalescing is performed.
	*/
	unsigned int bi_phys_segments;

	...

	struct bio_vec *bi_io_vec; /* the actual vec list */

	struct bio_set *bi_pool;

	/*
	* We can inline a number of vecs at the end of the bio, to avoid
	* double allocations for a small number of bio_vecs. This member
	* MUST obviously be kept at the very end of the bio.
	*/
	struct bio_vec bi_inline_vecs[0];
};
// 分配并初始化request_queue,绑定request_queue的处理函数,内存分配可能会失败,要检查返回值,用于使用request_queue的情况
request_queue_t *blk_init_queue(request_fn_proc *rfn, spinlock_t *lock);
void blk_cleanup_queue(request_queue_t * q); // 回收blk_init_queue分配的request_queue
// 用于ramdisk这种完全随机访问的块设备,绕过IO调度器,无需合并bio
request_queue_t *blk_alloc_queue(int gfp_mask);
void blk_queue_make_request(request_queue_t * q, make_request_fn * mfn); // 绑定blk_alloc_queue分配的request_queue的处理函数
struct request * blk_peek_request(struct request_queue *q); // 获取request_queue内的下一个request,不会清除队列
void blk_start_request(struct request *req); // 从队列中移除下一个request
struct request *blk_fetch_request(struct request_queue *q); // 同时完成获取并清除request
// 遍历request中的所有bio
#define __rq_for_each_bio(_bio, rq) \
	if ((rq->bio)) \
		for (_bio = (rq)->bio; _bio; _bio = _bio->bi_next)
// 遍历bio中的所有bio_vec
#define __bio_for_each_segment(bvl, bio, iter, start) \
	for (iter = (start); \
		(iter).bi_size && \
			((bvl = bio_iter_iovec((bio), (iter))), 1); \
		bio_advance_iter((bio), &(iter), (bvl).bv_len))
#define bio_for_each_segment(bvl, bio, iter) \
	__bio_for_each_segment(bvl, bio, iter, (bio)->bi_iter)
// 遍历rquest中的所有bio_vec
#define rq_for_each_segment(bvl, _rq, _iter) \
	__rq_for_each_bio(_iter.bio, _rq) \
		bio_for_each_segment(bvl, _iter.bio, _iter.iter)
void blk_end_request_all(struct request *rq, int error); // 报告request是否完成
void bio_endio(struct bio *bio, int error); // 用于blk_queue_make_request绕开io调度器的情况,报告bio是否完成
#define bio_io_error(bio) bio_endio((bio), -EIO) // 用于IO操作错误
IO调度器
负责在 I/O 请求被提交到块设备之前,对它们进行排序、合并和调度,旨在提高磁盘吞吐量并降低请求延迟。在Linux 4.0之前,块设备层主要采用单队列调度器。从Linux 3.13开始引入多队列调度器BLK-MQ,并在4.x系列内核中逐步成熟并成为默认框架。
- 传统单队列调度器:在 blk-mq 框架之前,I/O 调度器作用于一个全局请求队列。经典的 CFQ、Deadline、NOOP 都属于这个时代。
- 多队列调度器:随着 blk-mq 的引入,调度器的工作方式发生了变化。为了适配新的框架,内核为原有的调度器创建了对应的 “mq-” 版本,例如 mq-deadline。同时,也诞生了新的原生支持多队列的调度器,如 BFQ。
| 调度器 | 主要目标 | 最佳适用场景 | 特点 |
|---|---|---|---|
| None | 最大吞吐量,最低开销 | 高性能 NVMe SSD,虚拟化 | 无调度,直接传递请求 |
| MQ-Deadline | 防止请求饥饿,平衡延迟与吞吐 | 通用型,SSD,混合硬盘 | 简单可靠,许多发行版的默认选择 |
| BFQ | 公平性,低延迟(尤其对桌面) | 桌面系统,多用户环境 | 为进程公平分配带宽,响应快 |
| Kyber | 可预测的低延迟 | 数据库,云服务器,快速 SSD | 轻量级,基于目标延迟调整 |
| 通用建议: |
- 对于现代 NVMe SSD:none 或 kyber 通常能提供最佳性能。
- 对于 SATA SSD 或桌面系统:BFQ 能带来极佳的系统响应性;mq-deadline 是一个稳定可靠的选择。
- 对于机械硬盘:BFQ 或 mq-deadline 都是不错的选择。BFQ 在公平性上更优。
- 如果不确定:使用系统默认值(通常是 mq-deadline)通常不会出错。
# 查看可用调度器
cat /sys/block/sdX/queue/scheduler
# 临时修改调度器
echo bfq > /sys/block/sdX/queue/scheduler
# 永久更改调度器(使用 udev 规则)
ACTION=="add|change", KERNEL=="sda", SUBSYSTEM=="block", ATTR{queue/scheduler}="bfq"
# 永久更改调度器(使用内核参数)
elevator=<scheduler_name>
块设备驱动模版
static int xxx_init(void)
{
	/* 块设备驱动注册 */
	if (register_blkdev(XXX_MAJOR,"xxx")) {
		err = -EIO;
		goto out;
	}

	/* 请求队列初始化 */
	xxx_queue = blk_init_queue(xxx_request, xxx_lock);
	if (!xxx_queue)
	goto out_queue;
	blk_queue_max_hw_sectors(xxx_queue, 255); //通知通用块层和I/O调度器该请求队列支持的每个请求中能够包含的最大扇区数
	blk_queue_logical_block_size(xxx_queue, 512); // 告知该请求队列的逻辑块大小

	/* gendisk初始化 */
	xxx_disks->major = XXX_MAJOR;
	xxx_disks->first_minor = 0;
	xxx_disks->fops = &xxx_op;
	xxx_disks->queue = xxx_queue;
	sprintf(xxx_disks->disk_name,"xxx%d", i);
	set_capacity(xxx_disks, xxx_size *2);
	add_disk(xxx_disks); /* 添加gendisk */

	return 0;
out_queue:
	unregister_blkdev(XXX_MAJOR,"xxx");
out:
	put_disk(xxx_disks);
	blk_cleanup_queue(xxx_queue);
	return -ENOMEM;
}
// 由于块设备上面还有io调度层和文件系统层,不直接面向VFS,所以参数与inode及file结构无关
static int xxx_open(struct block_device *bdev, fmode_t mode)
{
	struct xxx_dev *dev = bdev->bd_disk->private_data;
	...
	return 0;
}

static void xxx_release(struct gendisk *disk, fmode_t mode)
{
	struct xxx_dev *dev = disk->private_data;
	...
}
// 高层的块设备层代码处理了绝大多数I/O控制,因此,在具体的块设备驱动中通常只需要实现与设备相关的特定ioctl命令
static int mmc_blk_ioctl(struct block_device *bdev, fmode_t mode, unsigned int cmd, unsigned long arg)
{
	int ret = -EINVAL;
	if (cmd == MMC_IOC_CMD)
	ret = mmc_blk_ioctl_cmd(bdev, (struct mmc_ioc_cmd __user *)arg);
	return ret;
}

struct block_device_operations xxx_op{
	.open = xxx_open,
	.release = xxx_release,
	.ioctl = mmc_blk_ioctl,
}
module_init(xxx_init);
使用request_queue的IO请求处理
static int xxx_init(void){
	/* 请求队列初始化 */
	xxx_queue = blk_init_queue(xxx_request, xxx_lock);
	xxx_disks->queue = xxx_queue;
	...
}

static void xxx_request(struct request_queue *q)
{
	struct memstick_dev *card = q->queuedata;
	struct msb_data *msb = memstick_get_drvdata(card);
	struct request *req = NULL;

	dbg_verbose("Submit request");
	// 设备已移除,报错
	if (msb->card_dead) {
		dbg("Refusing requests on removed card");

		WARN_ON(!msb->io_queue_stopped);

		while ((req = blk_fetch_request(q)) != NULL)
			__blk_end_request_all(req, -ENODEV);
		return;
	}

	if (msb->req)
		return;
	// 正常处理请求,遍历request中的bio并处理,也可使用工作队列异步处理
	if (!msb->io_queue_stopped){
		for_each_bio(bio){
			bio_for_each_segment(bvec, bio, iter){
				__blk_segment_map_sg(q, &bvec, sglist, &bvprv, sg,&nsegs, &cluster);
			}
		}
	}
}
不使用request_queue的IO请求处理
使用请求队列对于一个机械磁盘设备而言的确有助于提高系统的性能,但是对于RAMDISK、ZRAM(Compressed RAM Block Device)等完全可真正随机访问的设备而言,无法从高级的请求队列逻辑中获益。对于这些设备,块层支持“无队列”的操作模式。
static int xxx_init(void){
	// request_queue初始化,实际不包含任何请求,因为块层没有必要将bio调整为request
	xxx_queue = blk_alloc_queue(gfp_mask);
	blk_queue_make_request(xxx_queue, xxx_make_request);
	xxx_disks->queue = xxx_queue;
	...
}

static void xxx_make_request(struct request_queue *queue, struct bio *bio)
{
	struct memstick_dev *card = q->queuedata;
	struct msb_data *msb = memstick_get_drvdata(card);
	struct request *req = NULL;

	dbg_verbose("Submit request");
	// 设备已移除,报错
	if (msb->card_dead) {
		dbg("Refusing requests on removed card");

		WARN_ON(!msb->io_queue_stopped);
		bio_endio(bio, -ENODEV);
		return;
	}

	if (msb->req)
		return;
	// 遍历bio并处理每个bio_vec,也可使用工作队列异步处理
	if (!msb->io_queue_stopped){
		bio_for_each_segment(bvec, bio, iter) {
			zram_bvec_rw(zram, &bv, index, offset, bio);
	}
}
linux MMC子系统
Linux MMC/SD存储卡是一种典型的块设备,它的实现位于drivers/mmc。drivers/mmc下又分为card、core和host这3个子目录。card实际上跟Linux的块设备子系统对接,实现块设备驱动以及完成请求,但是具体的协议经过core层的接口,最终通过host完成传输。core目录除了给card提供接口外,实际上也定义好了host驱动的框架。
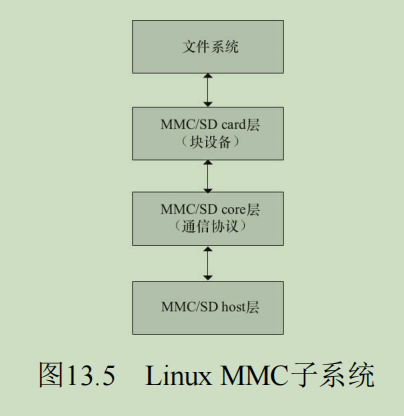 core层通过调用host层的mmc_host_ops结构中定义的函数集合,完成数据的传输。MMC主机驱动的主体工作就是实现该结构体的成员函数,如drivers/mmc/host/mmc_spi.c、drivers/mmc/host/bfin_sdh.c、drivers/mmc/host/sdhci.c等。由于目前大多数SoC内嵌的MMC/SD/SDIO控制器是SDHCI(Secure Digital Host Controller Interface),所以更多是直接重用drivers/mmc/host/sdhci.c驱动,很多芯片甚至还可以进一步使用基于drivers/mmc/host/sdhci.c定义的drivers/mmc/host/sdhci-pltfm.c框架。