在X86处理器中存在着I/O空间的概念,它通过特定的指令in、out来访问。端口号标识了外设的寄存器地址。
IN 累加器, {端口号│DX}
OUT {端口号│DX},累加器
目前,大多数嵌入式微控制器(如ARM、PowerPC等)中并不提供I/O空间,而仅存在内存空间。内存空间可以直接通过地址、指针来访问,程序及在程序运行中使用的变量和其他数据都存在于内存空间中。即便是在X86处理器中,虽然提供了I/O空间,如果由我们自己设计电路板,外设仍然可以只挂接在内存空间中。此时,CPU可以像访问一个内存单元那样访问外设I/O端口,而不需要设立专门的I/O指令。因此,内存空间是必需的,而I/O空间是可选的。
设备通常会提供一组寄存器来控制设备、读写设备和获取设备状态,即控制寄存器、数据寄存器和状态寄存器。这些寄存器可能位于I/O空间中,也可能位于内存空间中。当位于I/O空间时,通常被称为I/O端口;当位于内存空间时,对应的内存空间被称为I/O内存。
IO端口访问
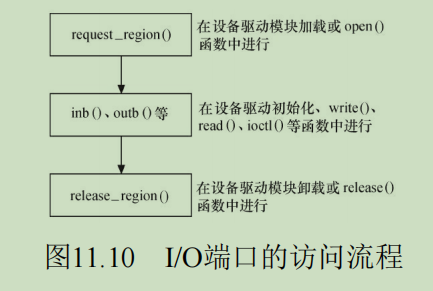
IO端口申请
IO端口在访问前需向linux内核的资源管理申请区域所有权,以防止资源冲突,保证资源的独占使用权。
struct resource *request_region(unsigned long first, unsigned long n, const char *name);
#define devm_request_mem_region(dev,start,n,name) ...
void release_region(unsigned long start, unsigned long n);
IO端口读写
// 读写字节(8位宽)
unsigned inb(unsigned port);
void outb(unsigned char byte, unsigned port);
// 读写字(16位宽)
unsigned inw(unsigned port);
void outw(unsigned short word, unsigned port);
// 读写长字(32位宽)
unsigned inl(unsigned port);
void outl(unsigned longword, unsigned port);
// 读写一串字节
void insb(unsigned port, void *addr, unsigned long count);
void outsb(unsigned port, void *addr, unsigned long count);
// 读写一串字
void insw(unsigned port, void *addr, unsigned long count);
void outsw(unsigned port, void *addr, unsigned long count);
// 读写一串长字
void insl(unsigned port, void *addr, unsigned long count);
void outsl(unsigned port, void *addr, unsigned long count);
IO内存访问
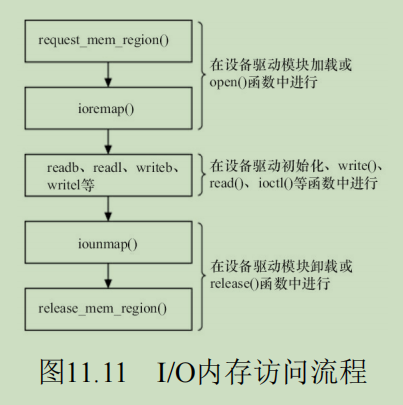
IO内存申请
和IO端口一样,在访问前需向linux内核的资源管理申请区域所有权,以防止资源冲突,保证资源的独占使用权。
struct resource *request_mem_region(unsigned long start, unsigned long len, char *name);
#define devm_request_region(dev,start,n,name) ...
void release_mem_region(unsigned long start, unsigned long len);
IO内存读写
在内核中访问I/O内存(通常是芯片内部的各个I2C、SPI、USB等控制器的寄存器或者外部内存总线上的设备)之前,需首先使用ioremap()函数将设备所处的物理地址映射到虚拟地址上。
void *ioremap(unsigned long offset, unsigned long size);
void __iomem *devm_ioremap(struct device *dev, resource_size_t offset,unsigned long size);
void iounmap(void * addr);
ioremap()与vmalloc()类似,也需要建立新的页表,但是它并不进行vmalloc()中所执行的内存分配行为。ioremap()返回一个特殊的虚拟地址,该地址可用来存取特定的物理地址范围,这个虚拟地址位于vmalloc映射区域。 虽然可以直接读写ioremap映射的内存,但推荐使用linux提供的api。没有_relaxed后缀的版本与有_relaxed后缀的 版本的区别是前者包含一个内存屏障。
#define readb(c) ({ u8 __v = readb_relaxed(c); __iormb(); __v; })
#define readw(c) ({ u16__v = readw_relaxed(c); __iormb(); __v; })
#define readl(c) ({ u32 __v = readl_relaxed(c); __iormb(); __v; })
#define writeb(v,c) ({ __iowmb(); writeb_relaxed(v,c); })
#define writew(v,c) ({ __iowmb(); writew_relaxed(v,c); })
#define writel(v,c) ({ __iowmb(); writel_relaxed(v,c); })
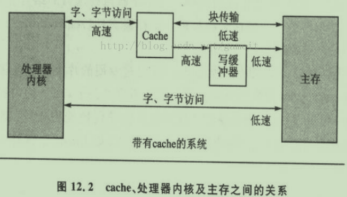
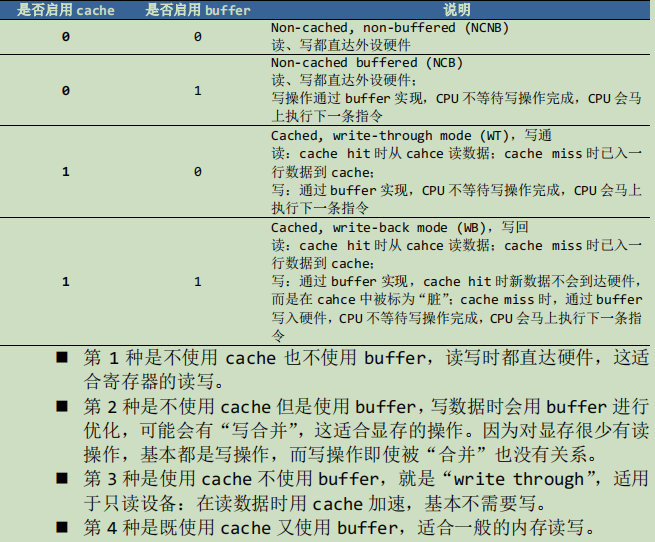
cache和写缓冲
mmap与内存映射
mmap()实现了这样的一个映射过程:它将用户空间的一段内存与设备内存关联,当用户访问用户空间的这段地址范围时,实际上会转化为对设备的访问。这种能力对于显示适配器一类的设备非常有意义,如果用户空间可直接通过内存映射访问显存的话,屏幕帧的各点像素将不再需要一个从用户空间到内核空间的复制的过程。mmap()必须以PAGE_SIZE为单位进行映射。 用户空间中的mmap函数原型:
caddr_t mmap (caddr_t addr, size_t len, int prot, int flags, int fd, off_t offset);当用户调用mmap()的时候,内核会进行如下处理。 1)在进程的虚拟空间查找一块VMA(虚拟内存区域,用vm_area_struct结构体描述)。 2)查找一块未使用的虚拟地址空间填充一个vm_area_struct结构。 3)使用上面的vm_area_struct为参数调用file_operations中的mmap()进行映射。 4)将这个VMA插入进程的VMA链表中。
file_operations中的mmap原型如下:
int(*mmap)(struct file * filep, struct vm_area_struct *vma)驱动程序中mmap()需要建立新的页表项,映射虚拟地址到物理地址,并填充VMA结构体中vm_operations_struct指针。
struct vm_area_struct {
	unsigned long vm_start; /* Our start address within vm_mm. */
	unsigned long vm_end; /* The first byte after our end address within vm_mm. */

	/* linked list of VM areas per task, sorted by address */
	struct vm_area_struct *vm_next,*vm_prev;
	struct rb_node vm_rb;
	...

	/* Second cache line starts here. */
	struct mm_struct *vm_mm; /* The address space we belong to. */
	pgprot_t vm_page_prot; /* Access permissions of this VMA. */
	unsigned long vm_flags; /* Flags, see mm.h. */
	...
	const struct vm_operations_struct *vm_ops;

	/* Information about our backing store: */
	unsigned long vm_pgoff; /* Offset (within vm_file) in PAGE_SIZE units,*not* PAGE_CACHE_SIZE */
	struct file * vm_file; /* File we map to (can be NULL). */
	void * vm_private_data; /* was vm_pte (shared mem) */
	...
};
struct vm_operations_struct {
	void (*open)(struct vm_area_struct * area);
	void (*close)(struct vm_area_struct * area);
	int (*fault)(struct vm_area_struct *vma, struct vm_fault *vmf);
	void (*map_pages)(struct vm_area_struct *vma, struct vm_fault *vmf);

	/* notification that a previously read-only page is about to become
	* writable, if an error is returned it will cause a SIGBUS */
	int (*page_mkwrite)(struct vm_area_struct *vma, struct vm_fault *vmf);

	/* called by access_process_vm when get_user_pages() fails, typically
	* for use by special VMAs that can switch between memory and hardware
	*/
	int (*access)(struct vm_area_struct *vma, unsigned long addr,
	void *buf, int len, int write);
	…
};
VMA结构体描述的虚地址介于vm_start和vm_end之间,而其vm_ops成员指向这个VMA的操作集。针对VMA的操作都被包含在vm_operations_struct结构体中。
file_operations.mmap中要做的事情如下:
- 确定物理地址
- 确定属性:是否使用 cache、buffer
- 建立映射关系
static int xxx_mmap(struct file *filp, struct vm_area_struct *vma)
{
	...
	phy_addr = vir_to_phy(kernle_buffer);
	vm->vm_pgoff = phy_addr >> PAGE_SHIFT;
	vma->vm_page_prot = pgprot_noncached(vma->vm_page_prot);/* 赋nocache标志 */
	if (remap_pfn_range(vma, vma->vm_start, vm->vm_pgoff, vma->vm_end - vma
	->vm_start, vma->vm_page_prot))/* 建立页表映射 */
		return -EAGAIN;
	vma->vm_ops = &xxx_remap_vm_ops;
	xxx_vma_open(vma);
	return 0;
}

static void xxx_vma_open(struct vm_area_struct *vma)/* VMA打开函数 */
{
	...
	printk(KERN_NOTICE "xxx VMA open, virt %lx, phys %lx\n", vma->vm_start,
	vma->vm_pgoff << PAGE_SHIFT);
}

static void xxx_vma_close(struct vm_area_struct *vma)/* VMA关闭函数 */
{
	...
	printk(KERN_NOTICE "xxx VMA close.\n");
}

static int xxx_fault(struct vm_area_struct *vma, struct vm_fault *vmf)
{
	unsigned long paddr;
	unsigned long pfn;
	pgoff_t index = vmf->pgoff;
	struct vma_data *vdata = vma->vm_private_data;
	...
	pfn = paddr >> PAGE_SHIFT;
	vm_insert_pfn(vma, (unsigned long)vmf->virtual_address, pfn);
	return VM_FAULT_NOPAGE;
}

static struct vm_operations_struct xxx_remap_vm_ops = {/* VMA操作结构体 */
	.open = xxx_vma_open,
	.close = xxx_vma_close,
	.fault = xxx_fault,
	...
};
vma->vm_ops在mmap中赋值,xxx_vma_open函数在mmap中被调用,xxx_vma_close会在用户调用munmap时被调用。mmap调用remap_pfn_range函数创建页表项。pgprot_noncached()是一个宏,用于设置映射内存的cache和写缓冲区属性,它高度依赖于CPU的体系结构。arm架构的pgprot的宏如下:
#define __pgprot_modify(prot,mask,bits)		\
	__pgprot((pgprot_val(prot) & ~(mask)) | (bits))

// 禁止相关页的cache和写缓冲
#define pgprot_noncached(prot) \
	__pgprot_modify(prot, L_PTE_MT_MASK, L_PTE_MT_UNCACHED)
// 仅禁止cache,不禁止写缓冲
#define pgprot_writecombine(prot) \
	__pgprot_modify(prot, L_PTE_MT_MASK, L_PTE_MT_BUFFERABLE)

#define pgprot_stronglyordered(prot) \
	__pgprot_modify(prot, L_PTE_MT_MASK, L_PTE_MT_UNCACHED)
remap_pfn_range
在驱动程序中,我们能使用remap_pfn_range()映射内存中的保留页、设备I/O、framebuffer、camera等内存。在remap_pfn_range()上又可以进一步封装出io_remap_pfn_range()、vm_iomap_memory()等API。
int remap_pfn_range(struct vm_area_struct *vma, unsigned long addr,unsigned long pfn, unsigned long size, pgprot_t prot);remap_pfn_range()函数为addr~addr+size的虚拟地址构造页表项。pfn是虚拟地址应该映射到的物理地址的页帧号,实际上就是物理地址右移PAGE_SHIFT位。若PAGE_SIZE为4KB,则PAGE_SHIFT为12,因为PAGE_SIZE等于1«PAGE_SHIFT。prot是新页所要求的保护属性。
fault回调
mmap除了调用remap_pfn_range以外,在驱动程序中实现VMA的fault()函数通常可以为设备提供更加灵活的内存映射途径。当发生缺页异常时,fault()会被内核自动调用,而fault()的具体行为可以自定义。这是因为当发生缺页异常时,系统会经过如下处理过程: 1)找到缺页的虚拟地址所在的VMA。 2)如果必要,分配中间页目录表和页表。 3)如果页表项对应的物理页面不存在,则调用这个VMA的fault()方法,它返回物理页面的页描述符。 4)将物理页面的地址填充到页表中。
IO内存静态映射
静态映射是在内核编译时或引导早期就建立的固定物理地址到虚拟地址的映射,与运行时动态的 ioremap() 相对应。 IO 内存静态映射是 Linux 内核在引导早期访问设备内存的重要机制,特别是在 ARM 等嵌入式架构中广泛使用。
/*
 * This structure defines static mappings for the kzm-arm11-01 board.
 */
static struct map_desc kzm_io_desc[] __initdata = {
	{
		.virtual	= (unsigned long)MX31_CS4_BASE_ADDR_VIRT,
		.pfn		= __phys_to_pfn(MX31_CS4_BASE_ADDR),
		.length		= MX31_CS4_SIZE,
		.type		= MT_DEVICE
	},
	{
		.virtual	= (unsigned long)MX31_CS5_BASE_ADDR_VIRT,
		.pfn		= __phys_to_pfn(MX31_CS5_BASE_ADDR),
		.length		= MX31_CS5_SIZE,
		.type		= MT_DEVICE
	},
};

/*
 * Set up static virtual mappings.
 */
static void __init kzm_map_io(void)
{
	mx31_map_io();
	iotable_init(kzm_io_desc, ARRAY_SIZE(kzm_io_desc));
}

static void __init kzm_timer_init(void)
{
	mx31_clocks_init(26000000);
}

MACHINE_START(KZM_ARM11_01, "Kyoto Microcomputer Co., Ltd. KZM-ARM11-01")
	.atag_offset = 0x100,
	.map_io = kzm_map_io,
	.init_early = imx31_init_early,
	.init_irq = mx31_init_irq,
	.init_time	= kzm_timer_init,
	.init_machine = kzm_board_init,
	.restart	= mxc_restart,
MACHINE_END
map_desc结构体用于描述一个静态映射,通过iotable_init函数建立映射。它通过MACHINE_START、MACHINE_END宏赋值开发板的map_io()回调函数完成静态映射的建立。
静态映射是旧驱动开发的内存定义方式,设备树已经在大多数情况下取代了静态映射,但是在内核启动早期,设备树未解析之前,早期设备的初始化依赖静态映射。
// 内核启动时间线:
start_kernel()
    ↓
setup_arch()           // 架构早期设置
    ↓
// 此时设备树尚未完全解析,但有些设备必须可用
early_console_init()   // 早期控制台需要静态映射
    ↓
early_timer_init()     // 早期定时器需要静态映射
    ↓
unflatten_device_tree() // 设备树解析(较晚!)
    ↓
device_initcall()      // 设备驱动初始化(更晚!)
静态映射没有运行时开销,还适合用在性能关键代码路径上。
DMA
DMA与cache一致性
如果DMA的目的地址与Cache所缓存的内存地址访问有重叠,经过DMA操作,与Cache缓存对应的内存中的数据已经被修改,而CPU本身并不知道,它仍然认为Cache中的数据就是内存中的数据,在以后访问Cache映射的内存时,它仍然使用陈旧的Cache数据。这样就会发生Cache与内存之间数据“不一致性”的错误。Cache的不一致性问题并不是只发生在DMA的情况下,实际上,它还存在于Cache使能和关闭的时刻。对于带MMU功能的ARM处理器,在开启MMU之前,需要先置Cache无效,对于TLB,也是如此。
/* 使cache无效 */
"mov r0, #0\n"
"mcr p15, 0, r0, c7, c7, 0\n" /* 使数据和指令cache无效 */
"mcr p15, 0, r0, c7, c10, 4\n" /* 清空写缓冲 */
"mcr p15, 0, r0, c8, c7, 0\n" /* 使TLB无效 */
DMA编程
内存中用于与外设交互数据的一块区域称为DMA缓冲区,在设备不支持scatter/gather(分散/聚集,简称SG)操作的情况下,DMA缓冲区在物理上必须是连续的。
虚拟地址、物理地址、总线地址
- 虚拟地址:进程看到的抽象地址,由MMU转换为物理地址。
// 进程隔离:每个进程有自己的地址空间
进程A: 0x400000 → 物理 0x80400000
进程B: 0x400000 → 物理 0x81400000  // 相同的VA,不同的PA!

// 内存保护:只读、只写、不可执行权限
// 内存过量使用:交换到磁盘
- 物理地址:内存控制器看到的地址,内存芯片上真实的硬件地址。
// 硬件层面的真实位置
// 内存控制器、缓存一致性协议直接使用
// 操作系统内核需要知道真实布局(NUMA、内存区域等)
- 总线地址:总线设备(DMA,外设)看到的地址,会被映射到物理地址上。
// 相同的总线地址,不同的物理地址!
设备A: 总线地址 0x1000 → 物理地址 0x80001000
设备B: 总线地址 0x1000 → 物理地址 0x80004000

// IOMMU 为设备提供类似MMU的功能,每个设备有自己的地址转换表
// 没有IOMMU:
设备总线地址 = 物理地址            // 直接映射
设备总线地址 = 物理地址 + 固定偏移  // 固定偏移映射

// 有IOMMU:
设备总线地址 → IOMMU转换 → 物理地址

// 好处:
// 1. 设备隔离:不同设备看到不同的地址空间
// 2. 安全:设备只能访问授权的内存区域
// 3. 灵活性:任意映射,不依赖硬件固定映射
     虚拟地址                                 总线地址
CPU ---------> MMU -> 物理地址 <- IOMMU/映射 <-------- 外设
还有一些系统提供了页面映射机制,它能将任意的页面映射为连续的外设总线地址。内核提供了如下函数以进行简单 的虚拟地址/总线地址转换:
unsigned long virt_to_bus(volatile void *address);
void *bus_to_virt(unsigned long address);
DMA地址掩码
设备并不一定能在所有的内存地址上执行DMA操作,在这种情况下应该通过下列函数执行DMA地址掩码:
int dma_set_mask(struct device *dev, u64 mask);
struct device {
	dma_mask;  // DMA缓冲区掩码
	coherent_dma_mask; // 一致性DMA缓冲区掩码
}
缓存一致的DMA缓冲区分配
内核中提供了如下函数以分配一个缓存一致的DMA内存区域:
void * dma_alloc_coherent(struct device *dev, size_t size, dma_addr_t *handle, gfp_t gfp);
void dma_free_coherent(struct device *dev, size_t size, void *cpu_addr, dma_addr_t handle);
void * dma_alloc_writecombine(struct device *dev, size_t size, dma_addr_t *handle, gfp_t gfp);
#define dma_free_writecombine(dev,size,cpu_addr,handle) dma_free_coherent(dev,size,cpu_addr,handle)
// pci设备申请DMA缓冲区
void * pci_alloc_consistent(struct pci_dev *pdev, size_t size, dma_addr_t *dma_addrp);
void pci_free_consistent(struct pci_dev *pdev, size_t size, void *cpu_addr, dma_addr_t dma_addr);dma_alloc_xxx()函数虽然是以dma_alloc_开头的,但是其申请的区域不一定在DMA区域里面。以32位ARM处理器为例,当coherent_dma_mask小于0xffffffff时,才会设置GFP_DMA标记,并从DMA区域去申请内存。
流式DMA映射
并不是所有的DMA缓冲区都是驱动申请的,如果是驱动申请的,用一致性DMA缓冲区自然最方便,这直接考虑了Cache一致性问题。但是,在许多情况下,缓冲区来自内核的较上层(如网卡驱动中的网络报文、块设备驱动中要写入设备的数据等),上层很可能用普通的kmalloc()、__get_free_pages()等方法申请,这时候就要使用流式DMA映射。
- 单个连续缓冲区映射
dma_addr_t dma_map_single(struct device *dev, void *buffer, size_t size, enum dma_data_direction direction);
void dma_unmap_single(struct device *dev, dma_addr_t dma_addr, size_t size, enum dma_data_direction direction);
通常情况下,设备驱动不应该访问映射的流式DMA缓冲区,如果一定要这么做,可先使用如下函数获得DMA缓冲区的拥有权,访问完后将所有权返还给设备:
void dma_sync_single_for_cpu(struct device *dev, dma_handle_t bus_addr, size_t size, enum dma_data_direction direction);
void dma_sync_single_for_device(struct device *dev, dma_handle_t bus_addr, size_t size, enum dma_data_direction direction);- SG模式的缓冲区映射 SG模式允许数据在物理内存中不连续,DMA控制器自动聚集数据并传输,可减少内存拷贝和内存碎片问题。基本使用流程如下:
#include <linux/scatterlist.h>
#include <linux/dma-mapping.h>

int setup_scatter_gather(struct device *dev,
                        void **buffers,
                        size_t *lengths,
                        int num_buffers)
{
    struct scatterlist *sg;
    int i, nents;

    // 1. 分配scatterlist数组
    sg = kmalloc_array(num_buffers, sizeof(struct scatterlist), GFP_KERNEL);
    if (!sg)
        return -ENOMEM;

    // 2. 初始化scatterlist表
    sg_init_table(sg, num_buffers);

    // 3. 设置每个分散的缓冲区
    for (i = 0; i < num_buffers; i++) {
        sg_set_buf(&sg[i], buffers[i], lengths[i]);
    }

    // 4. 映射SG列表用于DMA
    nents = dma_map_sg(dev, sg, num_buffers, DMA_TO_DEVICE);
    if (nents == 0) {
        kfree(sg);
        return -EIO;
    }

    // 5. 启动DMA传输(设备特定函数)
    start_dma_transfer(dev, sg, nents);

    return 0;
}

dma_addr_t sg_dma_address(struct scatterlist *sg); // 获取sg内存块的总线地址
unsigned int sg_dma_len(struct scatterlist *sg);   // 获取sg内存块的总长度
SG映射属于流式DMA映射,与单一缓冲区情况下的流式DMA映射类似,如果设备驱动一定要访问映射情况下的SG缓冲区,应该先调用如下函数:
void dma_sync_sg_for_cpu(struct device *dev, struct scatterlist *sg, int nents, enum dma_data_direction direction);
void dma_sync_sg_for_device(struct device *dev, struct scatterlist *sg, int nents, enum dma_data_direction direction);
dmaengine
dmaengine是 Linux 内核中一个统一的 DMA 控制器驱动框架,它提供了标准化的 API 来使用各种 DMA 控制器,是现代 Linux 内核中 DMA 编程的标准方式。 在没有 dmaengine 之前,每个 DMA 控制器都有自己独特的编程接口:
// 旧方式:每个控制器有自己的API
x86_dma_start(...);        // Intel DMA控制器
arm_pl080_start(...);      // ARM PL080 DMA控制器
omap_dma_submit(...);      // TI OMAP DMA控制器

// 驱动需要为每个平台写不同代码
#ifdef CONFIG_X86
    x86_dma_start(...);
#elif defined(CONFIG_ARM)
    arm_pl080_start(...);
#endif
dmaengine遵循如下使用流程:
- 申请DMA通道
#include <linux/dmaengine.h>
struct dma_chan *dma_chan;

// 通过名称申请特定通道
dma_chan = dma_request_chan(dev, "rx-tx");
if (IS_ERR(dma_chan)) {
    dev_err(dev, "无法获取DMA通道\n");
    return PTR_ERR(dma_chan);
}

// 或者通过of函数从设备树获取
dma_chan = of_dma_request_slave_channel(dev->of_node, "dma");- 配置从设备传输
// 配置DMA通道参数
struct dma_slave_config config = {
    .direction = DMA_MEM_TO_DEV,     // 传输方向:内存→设备
    .src_addr = 0,                   // 内存地址(稍后设置)
    .dst_addr = 0x48000000,          // 设备寄存器地址
    .src_addr_width = DMA_SLAVE_BUSWIDTH_4_BYTES,   // 源位宽
    .dst_addr_width = DMA_SLAVE_BUSWIDTH_4_BYTES,   // 目标位宽
    .src_maxburst = 8,               // 源最大突发长度
    .dst_maxburst = 8,               // 目标最大突发长度
};

int ret = dmaengine_slave_config(dma_chan, &config);
if (ret) {
    dev_err(dev, "DMA配置失败: %d\n", ret);
    goto err_release_chan;
}- 准备传输描述符
// 准备内存到设备的传输
struct scatterlist sg;
void *dma_buffer;
dma_addr_t dma_addr;

// 分配DMA缓冲区
dma_buffer = dma_alloc_coherent(dev, BUFFER_SIZE, &dma_addr, GFP_KERNEL);

// 初始化scatterlist(即使是单个缓冲区)
sg_init_table(&sg, 1);
sg_dma_address(&sg) = dma_addr;
sg_dma_len(&sg) = BUFFER_SIZE;

// 准备传输描述符
struct dma_async_tx_descriptor *tx_desc;
tx_desc = dmaengine_prep_slave_sg(dma_chan, &sg, 1,
                                 DMA_MEM_TO_DEV,
                                 DMA_PREP_INTERRUPT);
if (!tx_desc) {
    dev_err(dev, "无法准备DMA传输\n");
    goto err_free_buffer;
}

// 设置完成回调
tx_desc->callback = dma_transfer_complete;
tx_desc->callback_param = dev;- 提交并启动传输
// 提交传输到DMA控制器
dma_cookie_t cookie = dmaengine_submit(tx_desc);
if (dma_submit_error(cookie)) {
    dev_err(dev, "DMA提交失败\n");
    goto err_free_buffer;
}

// 启动传输
dma_async_issue_pending(dma_chan);

// 等待传输完成(可选)
enum dma_status status;
status = dma_wait_for_async_tx(cookie);
if (status != DMA_COMPLETE) {
    dev_err(dev, "DMA传输失败: %d\n", status);
}- 传输完成回调,传输完成后被自动调用
static void dma_transfer_complete(void *param)
{
    struct device *dev = param;

    dev_info(dev, "DMA传输完成\n");

    // 处理传输完成后的工作
    // 如:唤醒等待进程、启动下一个传输等
    complete(&dma_completion);
}