MMU(内存管理单元)
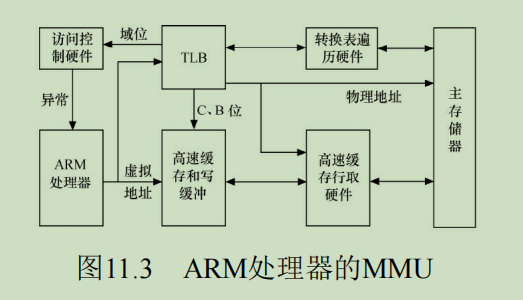
高性能处理器一般会提供一个内存管理单元(MMU),该单元辅助操作系统进行内存管理,提供虚拟地址和物理地址的映射、内存访问权限保护和Cache缓存控制等硬件支持。
MMU操作原理
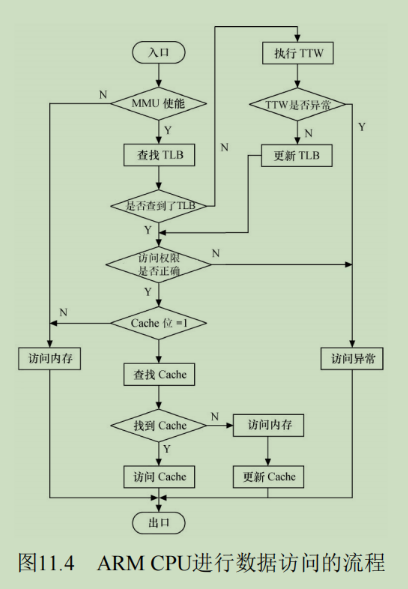
arm, powerPC, mips等架构处理器都有如下类似的MMU机制。具体的MMU管理器参考架构手册。 1)TLB(Translation Lookaside Buffer):即转换旁路缓存,TLB是MMU的核心部件,它缓存少量的虚拟地址与物理地址的转换关系,是转换表的Cache,因此也经常被称为“快表”。 2)TTW(Translation Table walk):即转换表漫游,当TLB中没有缓冲对应的地址转换关系时,需要通过对内存中转换表(大多数处理器的转换表为多级页表,如图11.2所示)的访问来获得虚拟地址和物理地址的对应关系。TTW成功后,结果应写入TLB中。
linux内存映射布局
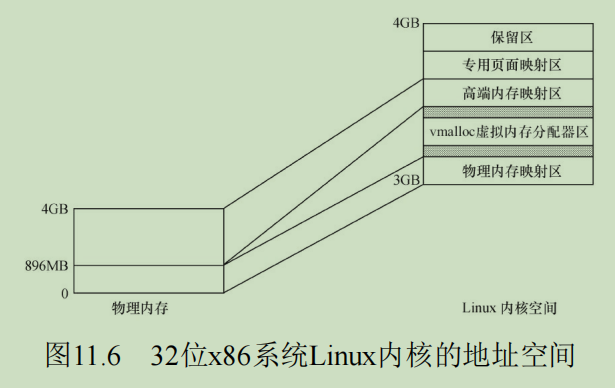
在Linux系统中,进程的4GB内存空间被分为两个部分——用户空间(03G)与内核空间(34G)。每个进程的用户空间都是完全独立、互不相干的,用户进程各自有不同的页表。而内核空间是由内核负责映射,它并不会跟着进程改变,是固定的。内核空间的虚拟地址到物理地址映射是被所有进程共享的,内核的虚拟空间独立于其他程序。
 32位ARM Linux的内核空间地址映射与x86不太一样,内核文档
Documentation/arm/memory.txt给出了ARM Linux的内存映射情况。
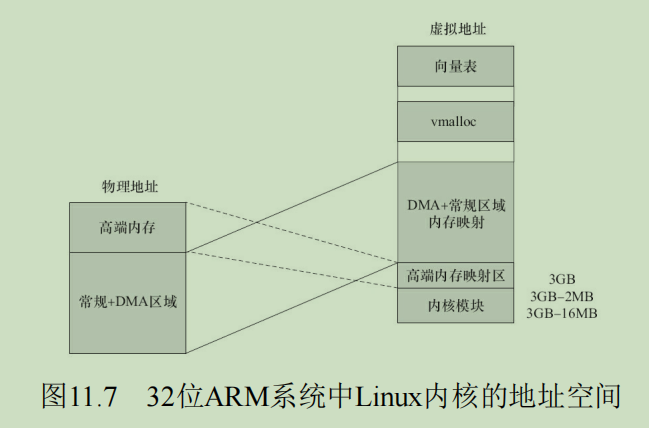 对于内核物理内存映射区的虚拟内存(即从DMA和常规区域映射过来的),使用virt_to_phys()可以实现内核虚拟地址转化为物理地址。phys_to_virt()将物理地址转化为内核虚拟地址。virt_to_phys()和phys_to_virt()方法仅适用于DMA和常规区域,高端内存的虚拟地址与物理地址之间不存在如此简单的换算关系。
对于大多数现代嵌入式处理器而言,DMA操作可以在整个常规内存区域进行,因此DMA区域就直接覆盖了常规内存。
linux内存管理
buddy内存分配器
DMA、常规、高端内存这3个区域都采用buddy算法进行管理,把空闲的页面以2^n为单位进行管理,因此Linux最底层的内存申请都是以2^n为单位的。下列函数可以使用buddy算法分配内存页:
__get_free_pages(unsigned int flags, unsigned int order);  // 分配2^order个页,不清零
unsigned long get_zeroed_page(gfp_t gfp_mask);  // 分配一个页,并清零
void __free_pages(struct page *page, unsigned int order); // 释放分配的页
上述函数在实现中调用了alloc_page函数进行空间分配,alloc_pages()既可以在内核空间分配,也可以在用户空间分配,参数含义与__get_free_pages()类似,但它返回分配的第一个页的描述符而非首地址:
struct page * alloc_pages(int gfp_mask, unsigned long order);使用GFP_KERNEL标志申请内存时,若暂时不能满足,则进程会睡眠等待页,即会引起阻塞,因此不能在中断上下文或持有自旋锁的时候使用GFP_KERNE申请内存。由于在中断处理函数、tasklet和内核定时器等非进程上下文中不能阻塞,所以此时驱动应当使用GFP_ATOMIC标志来申请内存。当使用GFP_ATOMIC标志申请内存时,若不存在空闲页,则不等待,直接返回。 其他的申请标志还包括:
GFP_KERNEL(用来为内核空间页分配内存,可能阻塞)
GFP_USER(用来为用户空间页分配内存,可能阻塞)
GFP_ATOMIC(不存在空闲页则直接返回,不阻塞)
GFP_HIGHUSER(类似GFP_USER,但是它从高端内存分配)
GFP_DMA(从DMA区域分配内存)
GFP_NOIO(不允许任何I/O初始化)
GFP_NOFS(不允许进行任何文件系统调用)
__GFP_HIGHMEM(指示分配的内存可以位于高端内存)
__GFP_COLD(请求一个较长时间不访问的页)
__GFP_NOWARN(当一个分配无法满足时,阻止内核发出警告)
__GFP_HIGH(高优先级请求,允许获得被内核保留给紧急状况使用的最后的内存页)
__GFP_REPEAT(分配失败,则尽力重复尝试)
__GFP_NOFAIL(标志只许申请成功,不推荐)
__GFP_NORETRY(若申请不到,则立即放弃)
slab内存分配器
slab分配器建立在buddy分配器基础上,slab将从buddy申请的页进行二次管理,以获取合适大小的内存。在操作系统的运作过程中,经常会涉及大量对象的重复生成、使用和释放内存问题。在Linux系统中所用到的对象,比较典型的例子是inode、task_struct等。如果我们能够用合适的方法使得对象在前后两次被使用时分配在同一块内存或同一类内存空间且保留了基本的数据结构,就可以大大提高效率,slab算法就是针对上述特点设计的。 slab可以高效分配固定大小的对象,减少内存碎片,提高缓存命中率,但在内存紧张的时候kmem_cache_alloc可能会分配失败并返回NULL,在某些情况下会睡眠(取决了传入的flag)。
// 创建slab缓存,size指定要划分的每个数据结构的大小
struct kmem_cache *kmem_cache_create(
	const char *name,
	size_t size,
	size_t align,
	unsigned long flags,
	void (*ctor)(void*, struct kmem_cache *, unsigned long),
	void (*dtor)(void*, struct kmem_cache *, unsigned long));
// 从创建的slab缓存中申请一块,返回指针
void *kmem_cache_alloc(struct kmem_cache *cachep, gfp_t flags);
// 释放从slab缓存中申请的块
void kmem_cache_free(struct kmem_cache *cachep, void *objp);
// 回收slab缓存
int kmem_cache_destroy(struct kmem_cache *cachep);
/* 创建slab缓存 */
static kmem_cache_t *xxx_cachep;
xxx_cachep = kmem_cache_create("xxx", sizeof(struct xxx), 0, SLAB_HWCACHE_ALIGN|SLAB_PANIC, NULL, NULL);
/* 分配slab缓存 */
struct xxx *ctx;
ctx = kmem_cache_alloc(xxx_cachep, GFP_KERNEL);
.../* 使用slab缓存 */
/* 释放slab缓存 */
kmem_cache_free(xxx_cachep, ctx);
kmem_cache_destroy(xxx_cachep);kmalloc
kmalloc()就是使用slab机制实现的。kmalloc的flag参数最终会传递给__get_free_pages。
void *kmalloc(size_t size, int flags);
void kfree(const void *objp);
vmalloc
vmalloc()一般只为存在于软件中(没有对应的硬件意义)的较大的顺序缓冲区分配内存,vmalloc()远大于__get_free_pages()的开销,为了完成vmalloc(),会进行内存的映射,改变页表项,不像kmalloc()实际用的是开机过程中就映射好的DMA和常规区域的页表项。因此vmalloc()的虚拟地址和物理地址不是一个简单的线性映射。只是调用vmalloc()来分配少量的内存(如1页以内的内存)是不妥的。vmalloc()不能用在原子上下文中,因为它的内部实现使用了标志为GFP_KERNEL的kmalloc(),可能会阻塞。
void *vmalloc(unsigned long size);
void vfree(void * addr);
内存池
虽然有了slab分配器,但是slab可能分配失败,且可能阻塞,内存池可保证关键路径代码的内存分配永不失败,在内存紧张的时候使用mempool_create预先分配的备用内存进行分配,且可用于紧急情况和不能睡眠的上下文中。内存池的备用内存需要额外的内存开销,但保证了可靠性。
typedef void *(mempool_alloc_t)(int gfp_mask, void *pool_data);
typedef void (mempool_free_t)(void *element, void *pool_data);
// 创建内存池,可传入alloc和free回调函数指定分配来源,只有当__GFP_WAIT标记被指定时,分配函数才会休眠。
mempool_t *mempool_create(int min_nr, mempool_alloc_t *alloc_fn,mempool_free_t *free_fn, void *pool_data);
// 分配和回收对象
void *mempool_alloc(mempool_t *pool, int gfp_mask);
void mempool_free(void *element, mempool_t *pool);
// 回收内存池
void mempool_destroy(mempool_t *pool);
如何选择内存分配器
// 1. 对于性能关键路径:使用slab
struct fast_obj *obj = kmem_cache_alloc(fast_cache, GFP_KERNEL);

// 2. 对于必须成功的分配:使用内存池
struct critical_obj *crit = mempool_alloc(crit_pool, GFP_KERNEL);

// 3. 对于大内存分配:直接使用伙伴系统
unsigned long pages = __get_free_pages(GFP_KERNEL, order);

// 4. 对于特定硬件:使用DMA内存池
void *dma_buf = dma_pool_alloc(dma_pool, GFP_KERNEL, &dma_handle);