并发导致的竞态条件
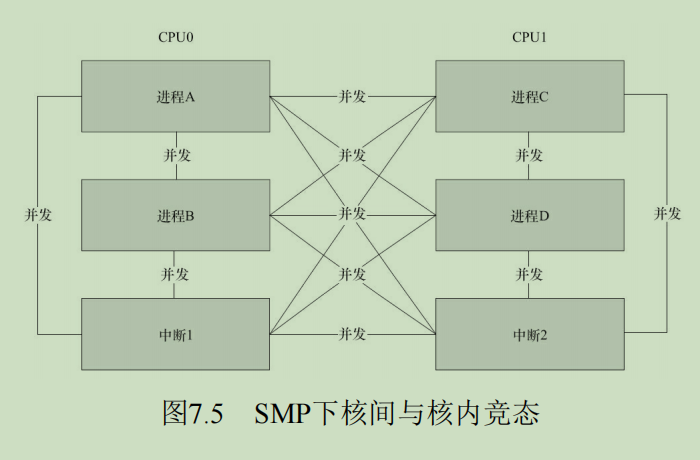
- SMP情况下多核间进程与进程、进程与中断的并发,可能产生核间竞态条件。
- 单cpu情况下,进程抢占、进程被中断打断、中断嵌套(2.6.35版本以后取消了中断嵌套),可能产生并发竞态条件。
解决竞态问题的途径是保证对共享资源的互斥访问,访问共享资源的代码区域称为临界区(Critical Sections),临界区需要被以某种互斥机制加以保护。中断屏蔽、原子操作、自旋锁、信号量、互斥体等是Linux设备驱动中可采用的互斥途径。
编译乱序和执行乱序导致的竞态条件
编译乱序
编译方面,如下线代码的程A编译结果指令顺序可能是gp的赋值指令发生在a、b、c的赋值之前,对于线程B来说这可能是不符合预期的,线程B访问到的a,b,c的值可能不是1,2,3。
// 线程A
p->a=1;
p->b=2;
p->c=3;
gp=p;

// 线程B
p = gp;
if (p != NULL) {
do_something_with(p->a, p->b, p->c);
}
解决编译乱序问题,需要通过barrier()编译屏障进行。我们可以在代码中设置barrier()屏障,这 个屏障可以阻挡编译器的优化。对于上述线程A的代码,加上barrier()后的结果如下:
p->a=1;
p->b=2;
p->c=3;
barrier();
gp=p;
执行乱序
执行乱序是指即便编译的二进制指令的顺序按照“p->a=1;p->b=2;p->c=3;gp=p;”排放,在处理器上执行时,后发射的指令还是可能先执行完,这是处理器的“乱序执行(Out-of-Order Execution)”策略。对于SMP的情况,CPU 1上的乱序执行对于CPU 0是不可见的,如下代码:
// cpu 0
while (f == 0);
print x;

// cpu 1
x = 42;
f = 1;
由于cpu的乱序执行策略,cpu 1不保证x=42一定在f=1前执行,执行时可能f=1先执行,这一乱序对cpu-0是不可见的,这会导致打印的x值可能不是42。解决此问题可以使用下面的DMB指令,DMB指令保证f=1执行前,x=42的赋值操作一定会完成:
// cpu 1
x = 42;
__asm__("dmb;");
f = 1;
处理器为了解决多核间一个核的内存行为对另外一个核不可见的问题,引入了一些内存屏障的指令。譬 如,ARM处理器的屏障指令包括:
- DMB(数据内存屏障):在DMB之后的显式内存访问执行前,保证所有在DMB指令之前的内存访问完成;
- DSB(数据同步屏障):等待所有在DSB指令之前的指令完成(位于此指令前的所有显式内存访问均完成,位于此指令前的所有缓存、跳转预测和TLB维护操作全部完成);
- ISB(指令同步屏障):Flush流水线,使得所有ISB之后执行的指令都是从缓存或内存中获得的。
Linux内核的自旋锁、互斥体等互斥逻辑,需要用到上述指令:在请求获得锁时,调用屏障指令;在解锁时,也需要调用屏障指令,如下是一个简单的互斥逻辑,内存屏障指令保证多核间正确的内存访问逻辑:
LOCKED EQU 1
UNLOCKED EQU 0
lock_mutex:
	; 互斥量是否锁定?
	LDREX r1, [r0] ; 检查是否锁定
	CMP r1, #LOCKED ; 和"locked"比较
	WFEEQ ; 互斥量已经锁定,进入休眠
	BEQ lock_mutex ; 被唤醒,重新检查互斥量是否锁定
	; 尝试锁定互斥量
	 MOV r1, #LOCKED
	 STREX r2, r1, [r0] ; 尝试锁定
	 CMP r2, #0x0 ; 检查STR指令是否完成
	 BNE lock_mutex ; 如果失败,重试
	 DMB ; 进入被保护的资源前需要隔离,保证互斥量已经被更新
	 BX lr

unlock_mutex:
	 DMB ; 保证资源的访问已经结束
	 MOV r1, #UNLOCKED ; 向锁定域写"unlocked"
	 STR r1, [r0]

	 DSB ; 保证在CPU唤醒前完成互斥量状态更新
	 SEV ; 像其他CPU发送事件,唤醒任何等待事件的CPU

	 BX lr
当程序访问外设的寄存器时,这些寄存器的访问顺序对CPU来说不构成逻辑上的依赖关系,但是从外设的逻辑角度来讲,可能需要固定的寄存器读写顺序,此时,也需要使用CPU的内存屏障指令。内核文档Documentation/memory-barriers.txt和Documentation/io_ordering.txt对此进行了描述。
中断屏蔽
中断屏蔽使得中断与进程之间的并发不再发生,从而避免了中断和进程间并发导致的竞态条件,且由于Linux内核的进程调度等操作都依赖中断来实现,单cpu上进程抢占之间的并发导致的竞态条件也得以避免了。中断屏蔽通常配合其他互斥对象一起使用。
local_irq_disable()    /* 屏蔽中断 */
//critical section       /* 临界区*/
local_irq_enable()     /* 开中断*/

local_irq_save(flag)   /*保存中断状态,支持临界区中嵌套设置中断状态*/
local_irq_restore(flag)
原子操作
原子操作可以保证对一个整型数据的修改是排他性的。arch/arm/include/asm/atomic.h中有如下代码:
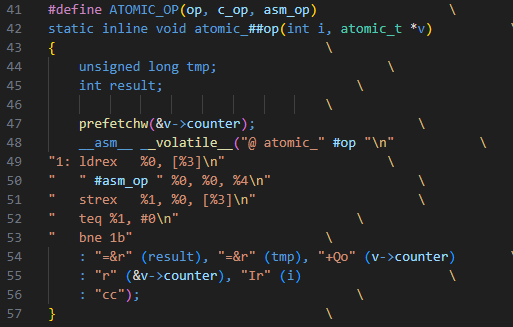
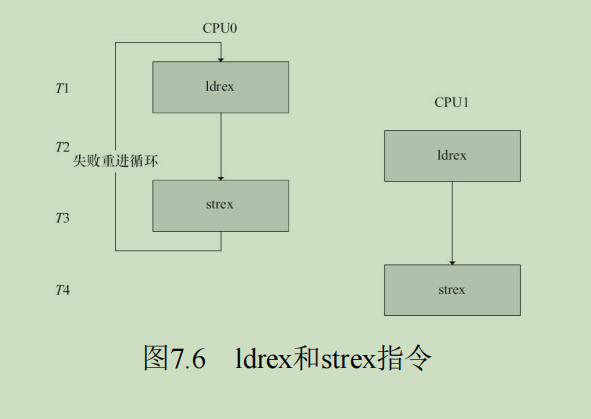 ldrex指令跟strex配对使用,可以让总线监控ldrex到strex之间有无其他的实体存取%3(&v->counter),如果有并发的访问,执行strex指令时,%1(tmp)的值被设置为1(Non-Exclusive Access)并且存储的行为也不成功;如果没有并发的存取,strex在%1(tmp)里设置0(Exclusive Access)并且存储的行为也是成功的。teq判断strex指令是否成功,不成功则跳转到标号1重试。
原子位操作函数:arch/arm/include/asm/bitops.h
锁
自旋锁
/* 定义一个自旋锁*/
spinlock_t lock;
spin_lock_init(&lock);
spin_lock (&lock) ; /* 获取自旋锁,保护临界区 */
. . ./* 临界区*/
spin_unlock (&lock) ; /* 解锁*/
自旋锁主要针对SMP或单CPU但内核可抢占的情况,linux上的自旋锁有三种实现:
- 在单cpu,不可抢占内核中,自旋锁为空操作。
- 在单cpu,可抢占内核中,自旋锁实现为“禁止内核抢占”,并不实现“自旋”。
- 在多cpu,可抢占内核中,自旋锁实现为“禁止内核抢占” + “自旋”。
虽然自旋锁可以保证临界区不受别的CPU和本CPU内的抢占进程打扰,但是得到锁的临界区还可能受到中断和底半部的影响。这时候就要和中断屏蔽配合使用,自旋锁机制和中断屏蔽结合形成了linux内核中的自旋锁机制:
spin_lock_irq() = spin_lock() + local_irq_disable()
spin_unlock_irq() = spin_unlock() + local_irq_enable()
spin_lock_irqsave() = spin_lock() + local_irq_save()
spin_unlock_irqrestore() = spin_unlock() + local_irq_restore()
spin_lock_bh() = spin_lock() + local_bh_disable()
spin_unlock_bh() = spin_unlock() + local_bh_enable()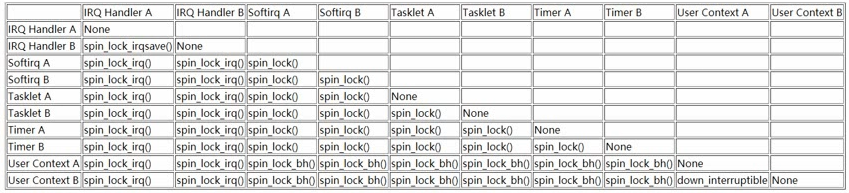 自旋锁的使用有如下限制条件:
- 自旋锁为忙等待,只有占有锁时间极短时使用自旋锁才是合理的。
- 自旋锁可能导致系统死锁,拥有一个锁的cpu尝试获取同一个锁时,该cpu将死锁。
- 自旋锁锁定期间不能调用可能引起进程调度的函数。如果进程获得自旋锁之后再阻塞,如调用copy_from_user()、copy_to_user()、kmalloc()和msleep()等函数,则可能导致内核的崩溃。
- 驱动强调夸平台,即便是单核cpu也应该当成多核cpu来编程,否则移植到多核后可能会造成多核并发问题。
读写锁
rwlock_t lock; /* 定义rwlock */
rwlock_init(&lock); /* 初始化rwlock */
/* 读时获取锁*/
read_lock(&lock);
... /* 临界资源 */
read_unlock(&lock);
/* 写时获取锁*/
write_lock_irqsave(&lock, flags);
... /* 临界资源 */
write_unlock_irqrestore(&lock, flags);
假设在A占有锁的情况下,B尝试获取同一个锁,有下列组合:
A      B      B状态
读     读      成功
读     写      自旋等待
写     读      自旋等待
写     写      自旋等待
读写锁允许同时读取,但有写操作时其它操作会自旋等待。
顺序锁
核心机制:序列号 + 重读
// 写操作,获取锁,此锁只用于写操作之间的互斥
write_seqlock_irqsave(&lock, flags);    // 序列号+1,变成奇数
... /* 临界资源 */
write_sequnlock_irqrestore(&lock, flags);   // 序列号+1,变成偶数

// 读操作,无需获取锁
do {
seqnum = read_seqbegin_irqsave(&seqlock_a); // 获取序列号,奇数表明发生了写操作,则让出cpu,并重试读取序列号,偶数则返回
/* 读操作代码块 */
...
} while (read_seqretry_irqrestore(&seqlock_a, seqnum));   // 判断序列号是否变换,发生变化则重读
假设在A占有锁的情况下,B尝试获取同一个锁,有下列组合:
A      B      B状态
读     读      成功
读     写      成功
写     读      成功
写     写      自旋等待
顺序锁允许最多只有一个写操作,读写操作并发时,可能引起重读。
顺序锁保证什么:
- 保证1:读者最终能获得某个时间点的完整数据快照
do {
    seq = read_seqbegin(&lock);
    // 读取操作...
} while (read_seqretry(&lock, seq));
// 退出循环时,读取的数据是某个一致状态
- 保证2:不会读取到部分更新的指针或损坏的数据
顺序锁不保证什么:
- 不保证1:单次读取获得最新数据,读者可能获得稍旧但一致的数据
- 不保证2:读取数据的实时性,在重试期间,数据可能已被多次修改
- 不保证3:避免重试,在高写入负载下,读者可能多次重试
读写锁vs顺序锁
为什么有了读写锁还需要顺序锁? 在实时系统中引起优先级反转问题:
- 低优先级任务持有读写锁(写者)
- 高优先级读者被阻塞 → 优先级反转问题 顺序锁解决:高优先级读者永远不会被阻塞,最多需要重试读取,但不会无限等待。
| 读写锁 | 顺序锁 | |
|---|---|---|
| 设计哲学 | 保证数据一致性 | 保证数据新鲜度+性能 |
| 适用场景 | 读多写少,数据一致性要求高 | 读多写多,双方访问频繁,读性能要求高 |
| 不适用场景 | 1. 写操作耗时长,读者会不断重试 2. 数据结构复杂,需要原子性视图 | |
| 核心权衡 | 保证数据一致性,可能牺牲性能 | 保证读者无阻塞和高性能,牺牲强一致性 |
| 读写时间比例: |
- 读:写 = 9:1 → 读写锁可能更好
- 读:写 = 1:1 → 顺序锁通常更好
- 读:写 = 1:9 → 顺序锁明显优势 写操作持续时间:
- 短写操作(<100周期)→ 顺序锁优
- 长写操作(>1000周期)→ 读写锁可能更好 如何选择:
if (写操作很频繁 && 写操作很快 && 读者可以接受重试) {
    使用顺序锁;
} else if (需要数据原子性视图 && 读多写少) {
    使用读写锁;
} else if (写很少) {
    使用RCU可能更好;  // 另一个选择
}
RCU(Read-Copy-Update,读-复制-更新)
https://www.kernel.org/doc/ols/2001/read-copy.pdf 不同于自旋锁,使用RCU的读端没有锁、内存屏障、原子指令类的开销,几乎可以认为是直接读(只是简单地标明读开始和读结束),而RCU的写执行单元在访问它的共享资源前首先复制一个副本,然后对副本进行修改,最后使用一个回调机制在适当的时机把指向原来数据的指针重新指向新的被修改的数据,这个时机就是所有引用该数据的CPU都退出对共享数据读操作的时候(既synchronize_rcu结束后)。等待适当时机的这一时期称为宽限期(Grace Period)。
// 链表写操作,
struct foo {
	struct list_head list;
	int a;
	int b;
	int c;
};
LIST_HEAD(head);
/* . . . */
p = search(head, key);
if (p == NULL) {
	/* Take appropriate action, unlock, and return. */
}
q = kmalloc(sizeof(*p), GFP_KERNEL);   // 复制节点并修改
*q = *p;
q->b = 2;
q->c = 3;
list_replace_rcu(&p->list, &q->list);   // 调用list_replace_rcu替换节点
synchronize_rcu();    // 等待synchronize_rcu返回后free旧节点
kfree(p);

// 链表读操作
rcu_read_lock();   // 标记读操作开始
list_for_each_entry_rcu(p, head, list) {
do_something_with(p->a, p->b, p->c);
}
rcu_read_unlock(); // 标记读操作结束,所有读操作都结束后,synchronize_rcu返回
rcu函数:
// 读锁定
rcu_read_lock()
rcu_read_lock_bh()
// 读解锁
rcu_read_unlock()
rcu_read_unlock_bh()
// 同步RCU,会阻塞
synchronize_rcu()
// 挂接回调,和上面的同步RCU选其中一个,不会阻塞,所有读操作结束后,执行回调
void call_rcu(struct rcu_head *head,void (*func)(struct rcu_head *rcu));
// 给RCU保护的指针赋一个新的值。
rcu_assign_pointer(p, v)
// 读端获取一个RCU保护的指针,并可以安全引用它访问指向的区域
rcu_dereference(p)
// 读端使用rcu_access_pointer()获取一个RCU保护的指针,但并不引用它,只关心指针的值,例如检查是否为NULL
rcu_access_pointer(p)
// RCU链表操作api
static inline void list_add_rcu(struct list_head *new, struct list_head *head);
static inline void list_add_tail_rcu(struct list_head *new,struct list_head *head);
static inline void list_del_rcu(struct list_head *entry);
static inline void list_replace_rcu(struct list_head *old, struct list_head *new);
list_for_each_entry_rcu(pos, head) // 该宏用于遍历RCU保护的链表head,在读执行单元临界区使用该函数,它就可以安全地和其他RCU保护的链表操作函数(如list_add_rcu())并发运行。
信号量
信号量(Semaphore)是操作系统中最典型的用于同步和互斥的手段,信号量的值可以是0、1或者n。 信号量与操作系统中的经典概念PV操作对应。 P(S):
- 将信号量S的值减1,即S=S-1;
- 如果S≥0,则该进程继续执行;否则该进程置为等待状态,排入等待队列。
V(S):
- 将信号量S的值加1,即S=S+1;
- 如果S>0,唤醒队列中等待信号量的进程。
struct semaphore sem;
void sema_init(struct semaphore *sem, int val);
void down(struct semaphore * sem);  // 会导致睡眠且无法被信号唤醒,禁止在中断中使用
int down_interruptible(struct semaphore * sem);   // 进入睡眠时可以被信号唤醒,此时返回非0值,禁止在中断中使用
int down_trylock(struct semaphore * sem);   // 不会导致睡眠,可以在中断中使用
void up(struct semaphore * sem);
二元信号量可用作互斥,但linux内核推荐使用互斥体(mutex),数值信号量用于生产者/消费者问题。
互斥体
struct mutex my_mutex;
mutex_init(&my_mutex);
void mutex_lock(struct mutex *lock);  // 会导致睡眠且无法被信号唤醒,禁止在中断中使用
int mutex_lock_interruptible(struct mutex *lock);  // 进入睡眠时可以被信号唤醒,此时返回非0值,禁止在中断中使用
int mutex_trylock(struct mutex *lock);  // 不会导致睡眠,可以在中断中使用
void mutex_unlock(struct mutex *lock);
互斥体vs自旋锁
自旋锁和互斥体都是解决互斥问题的基本手段,选择的依据是临界区的性质和系统的特点。
| 互斥体 | 自旋锁 | |
|---|---|---|
| 层次 | 进程级,内部依赖自旋锁保证互斥体结构存取的原子性 | 更底层,进程和内核都适用 |
| 引发进程切换 | 是,代表进程争夺资源,内核中使用可能引起进程切换 | 否 |
| 适用场景 | 1. 临界区时间长的代码 2. 临界区可以发生进程切换 | 1. 临界区时间短的代码 2. 临界区不能发生进程切换,否则死锁 |
完成量
用于一个执行单元等待另一个执行单元执行完某事。用于事件同步。
struct completion my_completion;
init_completion(&my_completion);
reinit_completion(&my_completion);
void wait_for_completion(struct completion *c);
void complete(struct completion *c);  // 只唤醒一个执行单元
void complete_all(struct completion *c);  // 唤醒所有等待此完成量的执行单元